
1단위. 디지털 이미지에서 특징과 표현으로
검토용 초고 v0.1 · 4.1–4.2 · 기술 자료 확인: 2026-09-13
4.1 인간의 시각과 디지털 이미지
사람이 알아보는 수목과 컴퓨터가 받는 입력
우리는 공원 사진에서 줄기와 잎을 보고 수목을 알아본다. 일부가 가려져 있어도 주변 형태와 경험을 이용해 대상을 짐작한다. 그러나 사진 파일 안에 “이것은 느티나무”라는 의미가 자동으로 들어 있는 것은 아니다. 프로그램이 먼저 받는 것은 정해진 위치에 배열된 숫자다. 그 숫자에서 어떤 정보를 추출하고 어떻게 학습했는지에 따라 대상을 구별하는 결과가 달라진다.
**컴퓨터 비전(computer vision)**은 영상 등의 시각 자료에서 대상의 종류·위치·형상·상태·움직임과 같은 정보를 계산하여 추정하는 분야다. 4장은 영상에서 의미를 추정하는 기본 원리에 집중한다. 사람의 시각 전체를 재현했다고 가정하기보다, 입력된 숫자가 특징과 표현을 거쳐 인식 결과로 바뀌는 과정을 이해하는 것이 목적이다.
기존 사진 판독에서도 색·경계·질감·그림자·주변 맥락을 함께 읽었다. 디지털 방법은 계산 가능한 단서를 수치로 표현하여 반복 사용할 수 있게 한다. 학습 기반 방법은 예시에서 유용한 표현을 조정한다. 두 접근을 이해하려면 먼저 디지털 이미지에 무엇이 저장되는지 알아야 한다.
픽셀·RGB·채널
**픽셀 또는 화소(pixel)**는 디지털 이미지를 구성하는 격자의 한 위치다. 회색조 영상에서는 각 위치에 밝기를 나타내는 값 하나를, 일반적인 RGB 영상에서는 빨강·초록·파랑에 해당하는 값 세 개를 저장한다. **채널(channel)**은 이러한 성분을 구분한 데이터 축이다. 같은 위치의 R·G·B 값은 서로 다른 세 위치가 아니라 한 위치의 세 성분이다.
가로 60픽셀, 세로 40픽셀인 RGB 영상의 픽셀 위치는 60×40=2,400개이고 색 성분값은 그 세 배인 7,200개다. 영상 속 수목의 개수는 이 수량에서 바로 나오지 않는다. 각 위치의 값과 그 배열을 해석해야 한다.
흔한 8비트 색 표현에서는 각 채널이 0부터 255까지의 정수로 기록된다. 하지만 모든 영상이 8비트이거나 모든 프로그램이 같은 채널 순서를 쓰지는 않는다. OpenCV에서 일반적으로 읽은 색 영상은 BGR 순서이므로 RGB로 가정하면 빨강과 파랑의 의미가 바뀐다. 자료형·채널 수·채널 순서도 입력의 의미를 결정한다. OpenCV 영상의 기본 연산
영상의 행·열과 실제 공간의 좌표도 구별한다. 사진의 100번째 열, 80번째 행을 찾았다는 결과는 영상 안의 위치다. 그 위치가 공원의 어디인지 알려면 좌표 연결에 필요한 정보가 더 있어야 한다. 이번 단위에서는 그 연결에 앞서 영상의 숫자와 배열을 살펴본다.
이미지 크기와 공간해상도
일상적으로 “해상도가 높다”는 말에는 여러 의미가 섞인다. 이미지 크기는 가로·세로 픽셀 수로 나타낼 수 있다. 공간해상도는 실제 공간에서 얼마나 작은 차이를 구별할 수 있는가와 관련된다. 원격탐사에서는 지상에서의 표본 간격인 **GSD(ground sample distance)**를 함께 사용하지만, 픽셀 간격만으로 실제 식별 능력을 모두 설명할 수는 없다. 렌즈·센서·흔들림·초점·처리 과정도 영향을 준다.
모두 1,000픽셀 너비인 두 영상이라도 한쪽은 공원 전체를, 다른 쪽은 벤치 하나를 담을 수 있다. 같은 픽셀 수에서 보이는 대상의 세부 수준은 다르다. 작은 영상을 보간해 크게 저장하면 픽셀 수는 늘어나지만 관측하지 않은 잎맥이나 균열이 새로 측정되는 것은 아니다. 생성형 복원이 만든 세부도 실제 관측 근거와 구별한다.
USGS 용어집도 공간해상도를 영상 시스템이 구별할 수 있는 지상 영역으로 설명한다. 조경에서는 “몇 메가픽셀 사진인가?”에 더해 “대상을 구별할 정보가 실제로 남아 있는가?”를 물어야 한다. 구체적인 촬영 조건은 5장으로 이어진다. USGS 공간해상도 용어
밝기·대비·색
밝기는 영상이나 그 일부가 밝고 어둡게 나타나는 정도이고, **대비(contrast)**는 주변과 얼마나 구별되는 차이가 있는가를 말한다. 색은 여러 채널 값의 관계로 표현된다. 밝기가 비슷한 영역이라도 색이 다를 수 있고, 같은 색의 대상도 조명과 노출에 따라 영상 값이 달라질 수 있다.
그늘 아래 수관과 햇빛을 받는 같은 수관을 비교하면 대상의 종류가 바뀌지 않아도 밝기와 색이 달라진다. 반대로 녹색 잎과 녹색 시설물은 다른 대상이지만 일부 채널 값이 비슷할 수 있다. 색 하나만으로 의미를 정하기 어려운 이유다.
**영상처리(image processing)**는 영상 값을 변환하거나 특정 표현을 계산하는 일이다. 밝기·대비 조정, 잡음 완화, 경계 강조가 그 예다. 정해진 값보다 밝은 픽셀과 그렇지 않은 픽셀을 나누는 임곗값 처리도 사용할 수 있다. 이런 규칙은 조건이 일정한 문제에 유용하지만 선택된 영역이 무엇을 뜻하는지는 별도로 정해야 한다. OpenCV 임곗값 처리
RGB 밖의 정보를 담는 영상
RGB는 사람이 볼 수 있는 빛을 세 성분으로 나타내는 일반적인 방식이다. **근적외선(NIR)**은 가시광선의 적색보다 긴 파장 쪽의 정보를 말하며 사람의 눈에 직접 보이지 않는다. 멀티스펙트럴 영상은 여러 파장 구간, 즉 밴드의 정보를 나누어 담는다. USGS의 Landsat 안내도 가시광선과 근적외선 등 밴드를 구분하여 설명한다. USGS 분광 밴드 안내
여기서 핵심은 채널이 반드시 화면에 보이는 색만을 뜻하지 않는다는 점이다. NIR을 빨간색으로 표시한 화면에서 붉게 보이는 영역은 실제로 붉은 잎이라는 뜻이 아니다. 화면 표시 방식과 센서가 무엇을 측정했는지를 구별해야 한다.
일반 RGB 사진의 색을 바꾸는 것만으로 NIR 관측값을 얻는 것도 아니다. 입력 채널이 늘어나면 모델이 받을 데이터의 구성과 처리 방법도 달라진다. 센서 선택·보정과 식생 해석의 상세 적용은 이후 관측 단위에서 다룬다.
4.2 특징은 무엇인가
경계·질감·형태를 수치로 나타내기
같은 나무를 약간 다른 방향에서 찍으면 픽셀 배열은 달라진다. 그런데도 우리는 두 사진에 비슷한 수관의 형태가 있다고 판단할 수 있다. 컴퓨터가 영상을 비교할 때에도 원래 숫자 전체를 그대로 대조하는 것 외에 목적에 유용한 정보로 바꾸는 방법이 필요하다.
**특징(feature)**은 대상을 구별하거나 비교하는 데 사용하도록 표현한 정보다. 평균 밝기, 경계의 방향, 반복 무늬의 정도처럼 사람이 계산 방법을 정할 수 있고 모델이 학습 중 만들어 내는 특징도 있다. 특징이 있다는 사실만으로 그것이 수종·재료·상태를 정확히 구분한다는 뜻은 아니다. 구별하려는 질문에 유용한지 확인해야 한다.
| 특징 | 의미 | 조경 장면의 단서 |
|---|---|---|
| 경계(edge) | 주변 픽셀 사이에서 값이 빠르게 변하는 부분 | 포장 가장자리, 수관 윤곽, 그림자 경계 |
| 질감(texture) | 영역에서 값이나 무늬가 반복·변화하는 공간적 성질 | 잔디의 잔무늬, 잎이 모인 수관, 포장 줄눈 |
| 형태(shape) | 영역이나 윤곽이 이루는 기하적 배치 | 길쭉한 시설물, 둥근 수관, 선형 포장 구간 |
경계를 찾는 연산은 밝기 변화의 크기와 방향을 수치로 계산할 수 있다. OpenCV의 Sobel·Scharr 안내가 그 예다. 하지만 강한 경계가 항상 물체의 경계는 아니다. 하나의 포장면 위에 생긴 그림자도 강한 밝기 변화를 만든다. OpenCV 영상 기울기
질감은 한 픽셀의 색이 아니라 주변 배열의 성질이다. 정해진 방향과 간격에 있는 밝기값 쌍이 얼마나 자주 함께 나타나는지 정리하는 회색조 동시발생 행렬(GLCM, gray-level co-occurrence matrix) 같은 전통적 방법도 있다. 관측 거리와 영역 크기가 달라지면 같은 포장이나 잔디의 질감도 다르게 나타날 수 있다. scikit-image는 GLCM에서 질감 특징을 구하는 방법을 제공한다. scikit-image 질감 특징 안내
평균은 같은데 다른 그림
특징을 고르는 효과를 4×4 회색조 격자 세 개로 살펴보자. 각 격자에는 밝기값 40인 픽셀 8개와 200인 픽셀 8개가 들어 있다. 평균 밝기는 모두 120이다. 이 한 값만 저장하면 세 격자를 구별할 수 없다.
첫 격자는 어두운 두 열과 밝은 두 열, 두 번째는 어두운 두 행과 밝은 두 행으로 구성한다. 세 번째는 어두운 칸과 밝은 칸을 번갈아 배치한다. 같은 밝기값의 수를 사용해도 경계 방향과 반복 무늬가 달라진다.
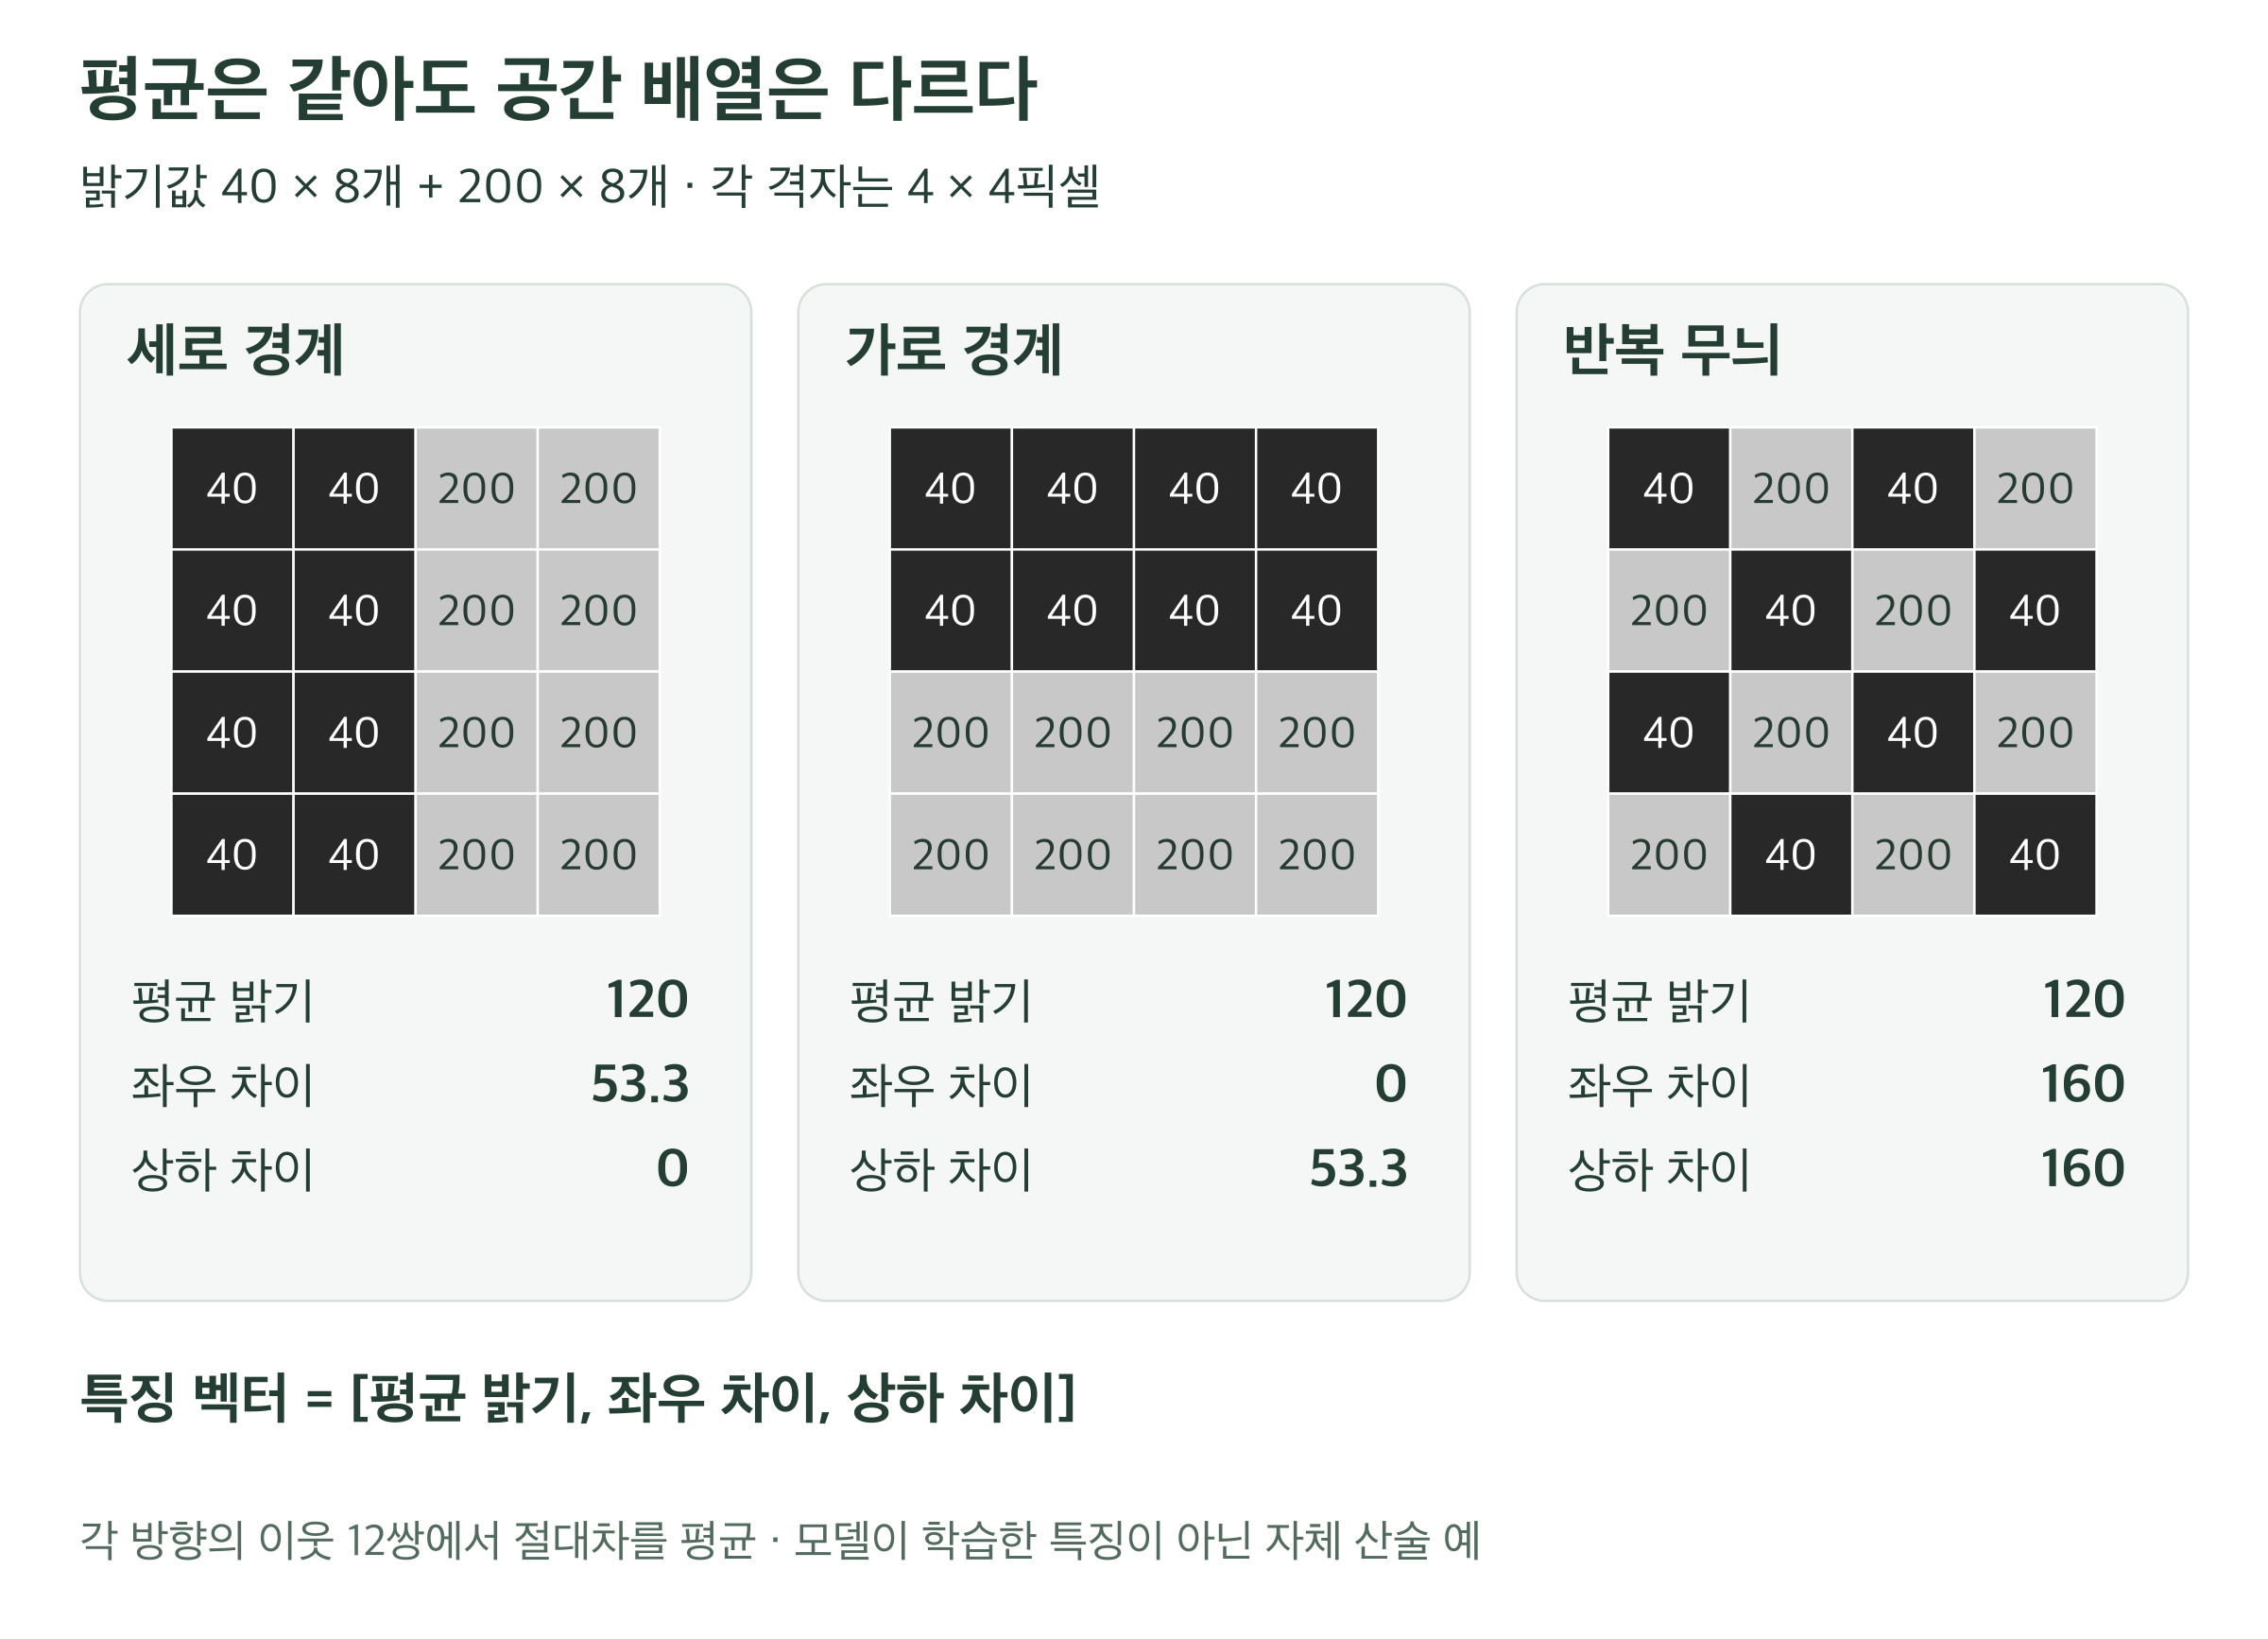
평균 밝기가 모두 120인 4×4 격자 세 개. 세로 경계는 좌우 이웃 차이만 크고, 가로 경계는 상하 이웃 차이만 크며, 반복 무늬는 두 방향의 차이가 모두 크다.
같은 평균, 다른 공간 배열. 자체 합성 격자이며 실제 포장·수목 영상이나 학습된 특징맵이 아니다. 차이값은 인접한 두 픽셀의 밝기 차이에 절댓값을 취한 뒤 해당 방향의 12쌍을 평균한 값이다. 소수는 한 자리로 표시했다.
여기서는 평균 밝기에 두 가지 특징을 더한다. 좌우로 붙은 픽셀들의 밝기 차이 평균과, 위아래로 붙은 픽셀들의 밝기 차이 평균이다. 차이의 부호는 쓰지 않고 크기만 사용한다. 이미지 바깥을 이어 붙이거나 빈 칸을 추가하지 않는다.
세로 경계 격자의 한 행에서 좌우 차이는 0, 160, 0이다. 같은 행이 네 개이므로 평균 차이는 약 53.3이다. 상하로는 같은 값끼리 이어져 차이가 0이다. 가로 경계에서는 두 방향의 결과가 반대가 된다. 번갈아 배치한 격자에서는 어느 방향으로 움직여도 이웃 값의 차이가 160이다.
**특징 벡터(feature vector)**는 여러 특징값을 정해진 순서로 묶은 수치 목록이다. [평균 밝기, 좌우 차이, 상하 차이]로 정하면 세 영상을 각각 [120, 53.3, 0], [120, 0, 53.3], [120, 160, 160]으로 나타낼 수 있다. 무엇이 어느 자리에 들어가는지 알아야 같은 기준으로 비교할 수 있다.
이 벡터는 영상을 복원할 수 있는 완전한 설명이 아니다. 서로 다른 배열이 같은 벡터를 가질 수도 있다. 다만 평균 하나가 놓친 방향과 반복 변화의 일부를 추가했다. 어떤 정보를 남기고 어떤 차이를 줄일지 선택하는 과정이 표현의 핵심이다.
사람이 정한 특징과 학습된 특징
위 예에서는 사람이 “좌우 차이를 계산하자”라고 방법을 정했다. 이런 설계된 특징은 계산의 의미를 설명하기 쉽다. 색 분포나 경계 방향을 정리하는 전통적 방법도 같은 관점에서 이해할 수 있다. 반면 수종·전정 형태·재료처럼 여러 단서가 섞인 문제에서는 필요한 규칙을 모두 직접 만들기 어렵다.
이 장에서 **모델(model)**은 입력을 특징이나 예측 결과로 바꾸는 계산 구조를 뜻한다. **학습(training)**은 자료와 목적에 맞추어 그 구조의 조정 가능한 값을 정하는 과정이고, **추론(inference)**은 정해진 모델에 입력을 넣어 결과를 계산하는 과정이다.
**학습된 특징(learned feature)**은 모델이 학습 목적에 맞추어 조정한 연산에서 얻는 표현이다. 사람이 모든 경계나 무늬의 검출 규칙을 작성하는 대신, 자료를 통해 유용한 패턴에 반응하도록 연산의 값을 조정한다. 특징을 계산하고 여러 층에서 조합하는 방식은 CNN과 ViT에서 다르게 구성된다.
각 숫자에 항상 “잎”, “줄기”, “건강”처럼 사람이 읽을 이름을 붙일 수 있는 것은 아니다. 여러 특징이 함께 대상을 구분하고, 한 특징이 배경이나 조명 같은 원치 않는 단서에 반응할 수도 있다. CS231n의 특징 시각화 안내 역시 단일 뉴런의 반응에 고정된 의미가 있다고 가정하지 않도록 설명한다. CS231n 학습된 특징의 해석
임베딩과 표현학습
**표현(representation)**은 자료를 계산 목적에 맞게 나타낸 형태다. 픽셀 배열도 표현이고 앞의 세 숫자로 된 특징 벡터도 표현이다. **표현학습(representation learning)**은 자료를 구별하고 비교하는 데 유용한 표현을 학습하는 일이다.
**임베딩(embedding)**은 자료를 벡터 공간의 수치로 대응시킨 표현이다. 이 책에서는 주로 모델이 학습한 영상 임베딩을 다룬다. 정의상 모든 임베딩이 반드시 학습으로 만들어지는 것은 아니며, 각 축이 사람이 정한 물리량일 필요도 없다. 앞에서 직접 계산한 세 특징값과 학습된 임베딩을 같은 결과인 것처럼 혼동하지 않는다.
임베딩의 직관은 비슷하다고 표현된 자료들이 벡터 공간에서 가까워질 수 있다는 것이다. 그러나 어떤 의미에서 비슷한가는 학습 목적에 달려 있다. 같은 재료를 구별하도록 만든 표현과 같은 색을 비교하는 표현은 사진들을 다르게 배열할 수 있다. 같은 수종이 언제나 가까이 놓이거나, 가까운 벡터가 같은 실제 개체를 뜻한다고 보장할 수 없다. 사용하는 거리와 값의 정규화도 비교에 영향을 준다. Google 임베딩 공간 안내
비슷한 포장 사진을 찾아 보여주는 기능을 생각하면 이해하기 쉽다. 표현이 표면 색에 주로 반응하면 재료는 달라도 색이 비슷한 사진을 가까이 놓을 수 있다. 재료 구분에 유용한 질감과 형태를 반영한다면 조명이 달라진 같은 재료를 더 잘 연결할 가능성이 있다. 어느 쪽으로 작동하는지는 실제 자료에서 확인해야 한다.
DINOv2 같은 연구는 여러 과제에서 재사용할 수 있는 시각 특징을 사전학습하는 방향을 보여준다. 여기서는 그러한 방법론이 있다는 정도로 연결한다. 모델의 조경 성능을 확인하거나 임베딩을 실제로 생성한 것은 아니다. 사전학습·전이학습·기반모델의 선택은 4.6에서 다룬다. DINOv2 원 논문
다음 단위에서는 작은 영역에 같은 연산을 적용하는 CNN과 패치 표현 사이의 관계를 계산하는 ViT가 이러한 표현을 어떻게 만드는지 설명한다. 인식 과제, 결과의 평가와 불확실성은 그다음에 연결한다.
자체 계산 자료: 세 격자의 밝기와 특징값. 합성 격자의 산술만 계산했으며 CNN·ViT 학습, 임베딩 생성, 실제 영상 추론과 성능평가는 실행하지 않았다. 가로 60×세로 40픽셀의 RGB 산술 예는 그림의 4×4 격자와 별개의 예다.
2단위. CNN과 ViT의 인식 원리
검토용 초고 v0.1 · 4.3–4.4 · 기술 자료 확인: 2026-09-13
앞 단위에서는 평균 밝기가 같은 영상도 경계 방향과 반복 무늬로 구별할 수 있음을 보았다. 이번에는 이러한 특징을 여러 단계에서 만들고 연결하는 두 가지 구조를 살펴본다. 하나는 작은 영역에 같은 연산을 반복하는 CNN이고, 다른 하나는 영상 조각들의 관계를 계산하는 Vision Transformer다.
4.3 CNN은 이미지를 어떻게 읽는가
가까운 픽셀을 함께 계산하는 이유
포장 줄눈은 사진의 왼쪽에도 오른쪽에도 나타난다. 수관 가장자리도 특정 위치에만 존재하지 않는다. 영상의 모든 위치에 서로 다른 판독 규칙을 만드는 대신, 같은 작은 패턴을 여러 위치에서 찾을 수 있으면 유용하다.
**합성곱 신경망(CNN, convolutional neural network)**은 합성곱 연산 등을 여러 층으로 연결하여 영상의 표현을 만드는 신경망이다. **층(layer)**은 입력을 받아 다음 표현으로 바꾸는 계산 단계다. 기본 합성곱 층에서는 주변 영역을 함께 계산하는 국소 연결과, 같은 계수를 여러 위치에 적용하는 가중치 공유가 중요하다. 가중치는 입력값이 출력에 기여하는 방식을 조절하는 수치다.
이 구조는 영상에 이미 있는 이웃 관계를 활용한다. 공간적 패턴이 다른 위치에서도 반복될 수 있다는 가정을 계산 구조에 넣은 것이다. CS231n 합성곱 신경망 안내
필터를 움직이며 특징맵 만들기
**필터 또는 커널(filter/kernel)**은 작은 영역의 입력값에 곱할 계수를 모은 배열이다. 해당 영역에서 위치가 대응하는 값끼리 곱하고 더하면 출력 하나를 얻는다. 필터를 옮겨 같은 계산을 반복하면 출력값도 공간 배열을 이룬다. 이를 **특징맵(feature map)**이라고 한다.
아래 그림은 앞 단위의 세로 경계 격자를 그대로 사용한다. 왼쪽 두 열의 밝기는 40, 오른쪽 두 열은 200이다. 설명용 2×2 필터의 각 행을 [-1, 1]로 정한다. 이 필터는 두 행에서 오른쪽 값과 왼쪽 값의 차이를 더한다.
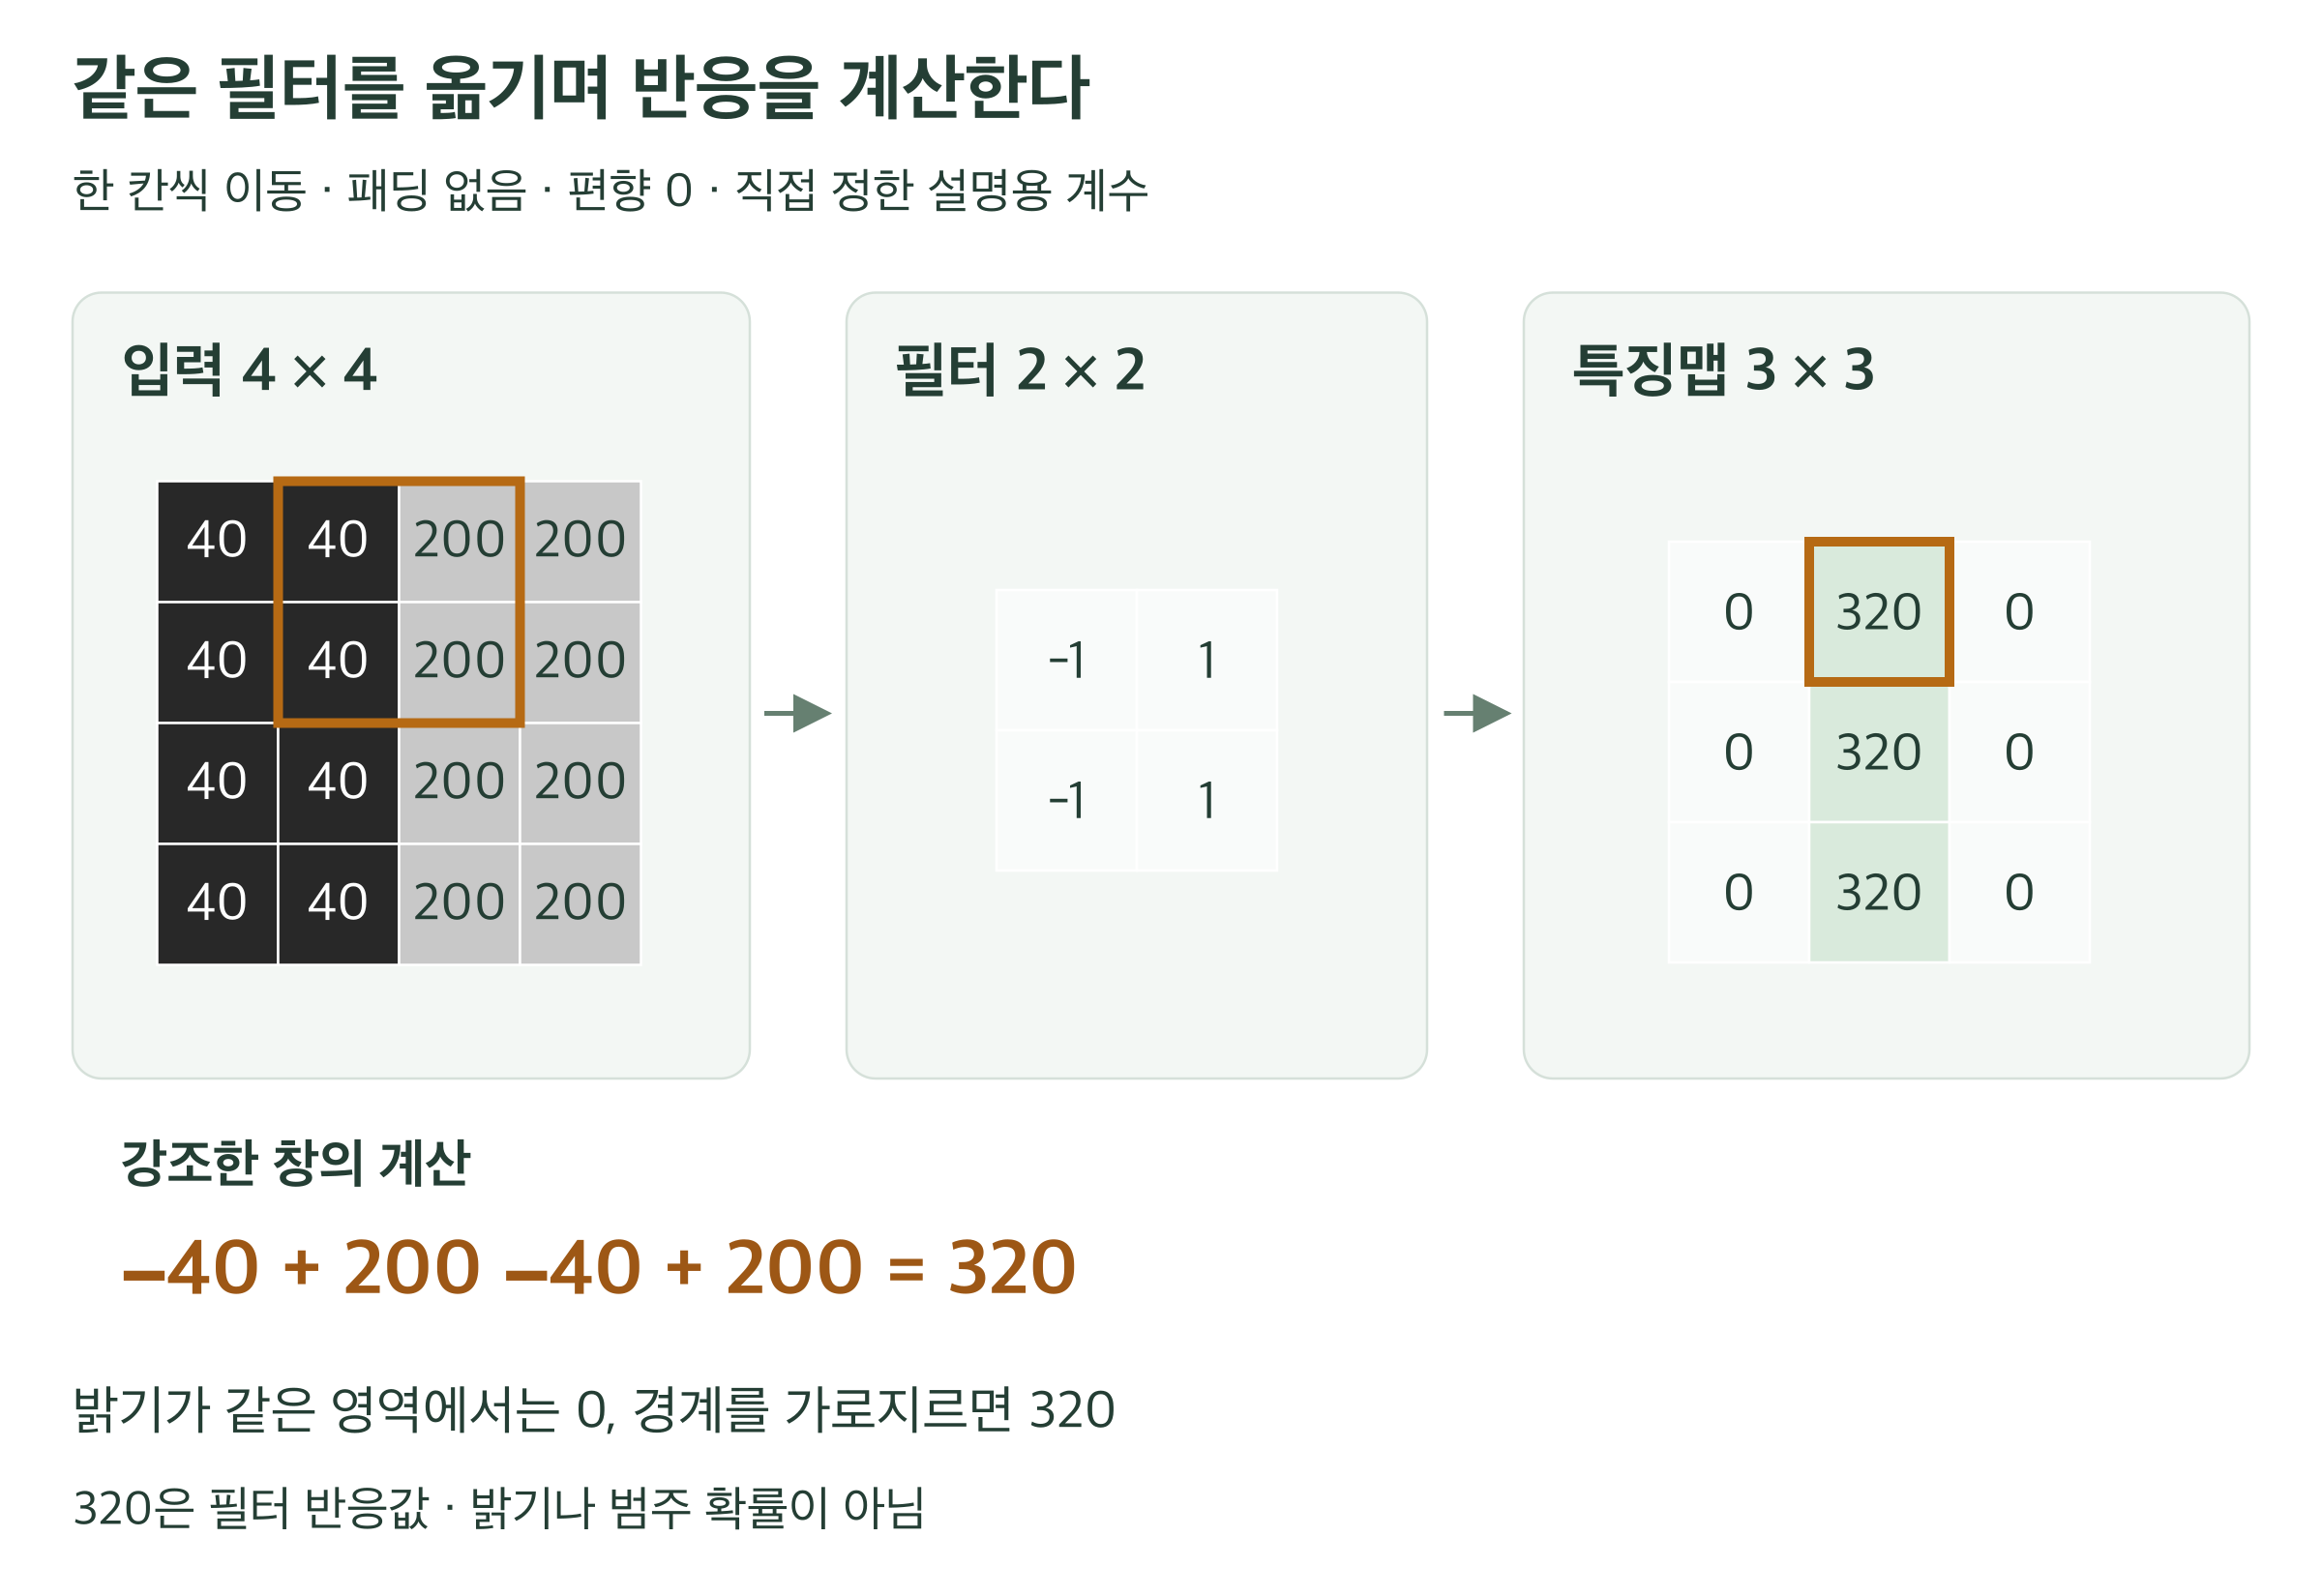
4×4 세로 경계 격자에 2×2 필터를 적용한다. 각 행이 마이너스 1과 1인 필터를 한 칸씩 이동하면 3×3 출력의 각 행은 0, 320, 0이다. 경계를 가로지르는 창과 출력 320을 함께 강조한다.
자체 계산 예. 한 칸씩 이동하고, 바깥에 값을 덧대지 않으며, 편향은 0으로 둔다. 강조한 위치의 계산은 −40+200−40+200=320이다. 계수는 설명을 위해 직접 정했으며 학습된 수목 검출기가 아니다.
처음 창에는 40만 네 개가 들어가므로 차이가 0이다. 오른쪽으로 한 칸 옮기면 각 행에 40과 200이 들어가 320이 된다. 다시 옮기면 200만 들어가 차이가 0이다. 세로 방향으로 이동해도 같은 배열이므로 출력의 세 행은 모두 [0, 320, 0]이다.
필터가 4×4 입력 안에 완전히 들어가는 위치는 가로·세로 세 곳씩, 총 아홉 곳이다. 이때 특징맵은 3×3이다. **스트라이드(stride)**는 필터를 옮기는 간격이고, **패딩(padding)**은 경계 계산을 위해 입력 바깥에 값을 덧대는 방식이다. 간격과 경계 처리에 따라 출력 크기와 가장자리의 결과가 달라진다.
단일 채널, 스트라이드 1인 경우의 계산을 한 식으로 쓰면 다음과 같다.
여기서 x는 입력, w는 필터 계수, b는 출력에 더하는 **편향(bias)**이다. r,c는 창의 시작 위치, u,v는 창 안의 위치이고 kh,kw는 필터의 높이와 너비다. 그림에서는 b=0이다. 식을 외우기보다 같은 계수를 위치가 다른 작은 입력에 반복 적용한다는 점을 읽으면 된다.
딥러닝에서 합성곱 층이라고 부르는 연산은 흔히 커널을 뒤집지 않는 **상호상관(cross-correlation)**으로 구현된다. 위 식과 예도 이 관례를 따른다. PyTorch의 Conv2d 문서도 연산을 이 방식으로 정의한다. PyTorch Conv2d 연산 정의
출력 320은 밝기값도, 경계일 확률 320%도 아니다. 선택한 필터의 반응값이다. 밝고 어두운 쪽을 바꾸면 같은 필터의 반응 부호가 바뀐다. 또한 포장 줄눈과 그림자 경계는 모두 이 연산에 반응할 수 있다. 반응을 계산하는 단계와 그 의미를 판정하는 단계가 다르다.
여러 필터와 비선형 변환
필터 하나로는 모든 패턴을 표현하기 어렵다. 여러 필터를 사용하면 위치마다 여러 반응값이 생기고, 이들이 출력 채널을 이룬다. RGB 입력을 다루는 일반적인 합성곱은 각 입력 채널의 값을 함께 계산하여 출력 채널을 만든다. 채널의 의미는 입력의 R·G·B에서 학습된 특징 성분으로 바뀔 수 있다.
합성곱 뒤에는 흔히 **활성화 함수(activation function)**를 적용한다. 대표적인 ReLU는 음수를 0으로 바꾸고 양수는 유지하는 비선형 연산이다. 이런 비선형 변환을 함께 사용해야 여러 층에서 더 다양한 관계를 표현할 수 있다. ReLU가 남긴 양수에 수목이라는 의미가 자동으로 붙는 것은 아니다. CS231n 층과 활성화의 설명
작은 연산을 쌓으면 보는 범위가 넓어진다
**수용영역(receptive field)**은 특정 출력값에 계산 경로를 통해 영향을 줄 수 있는 입력 영역이다. 한 층에서 작은 창만 사용하더라도 다음 층은 그 창들의 결과를 다시 함께 계산한다.
예를 들어 3×3 합성곱을 연속해서 적용하고, 각 층의 스트라이드와 필터 내부 간격을 1로 두자. 경계 영향을 받지 않는 출력 한 점이 참조할 수 있는 원래 입력 범위는 한 층 뒤 3×3, 두 층 뒤 5×5, 세 층 뒤 7×7로 넓어진다. 다음 그림은 계산 경로상의 범위를 같은 입력 격자 위에서 비교한다.
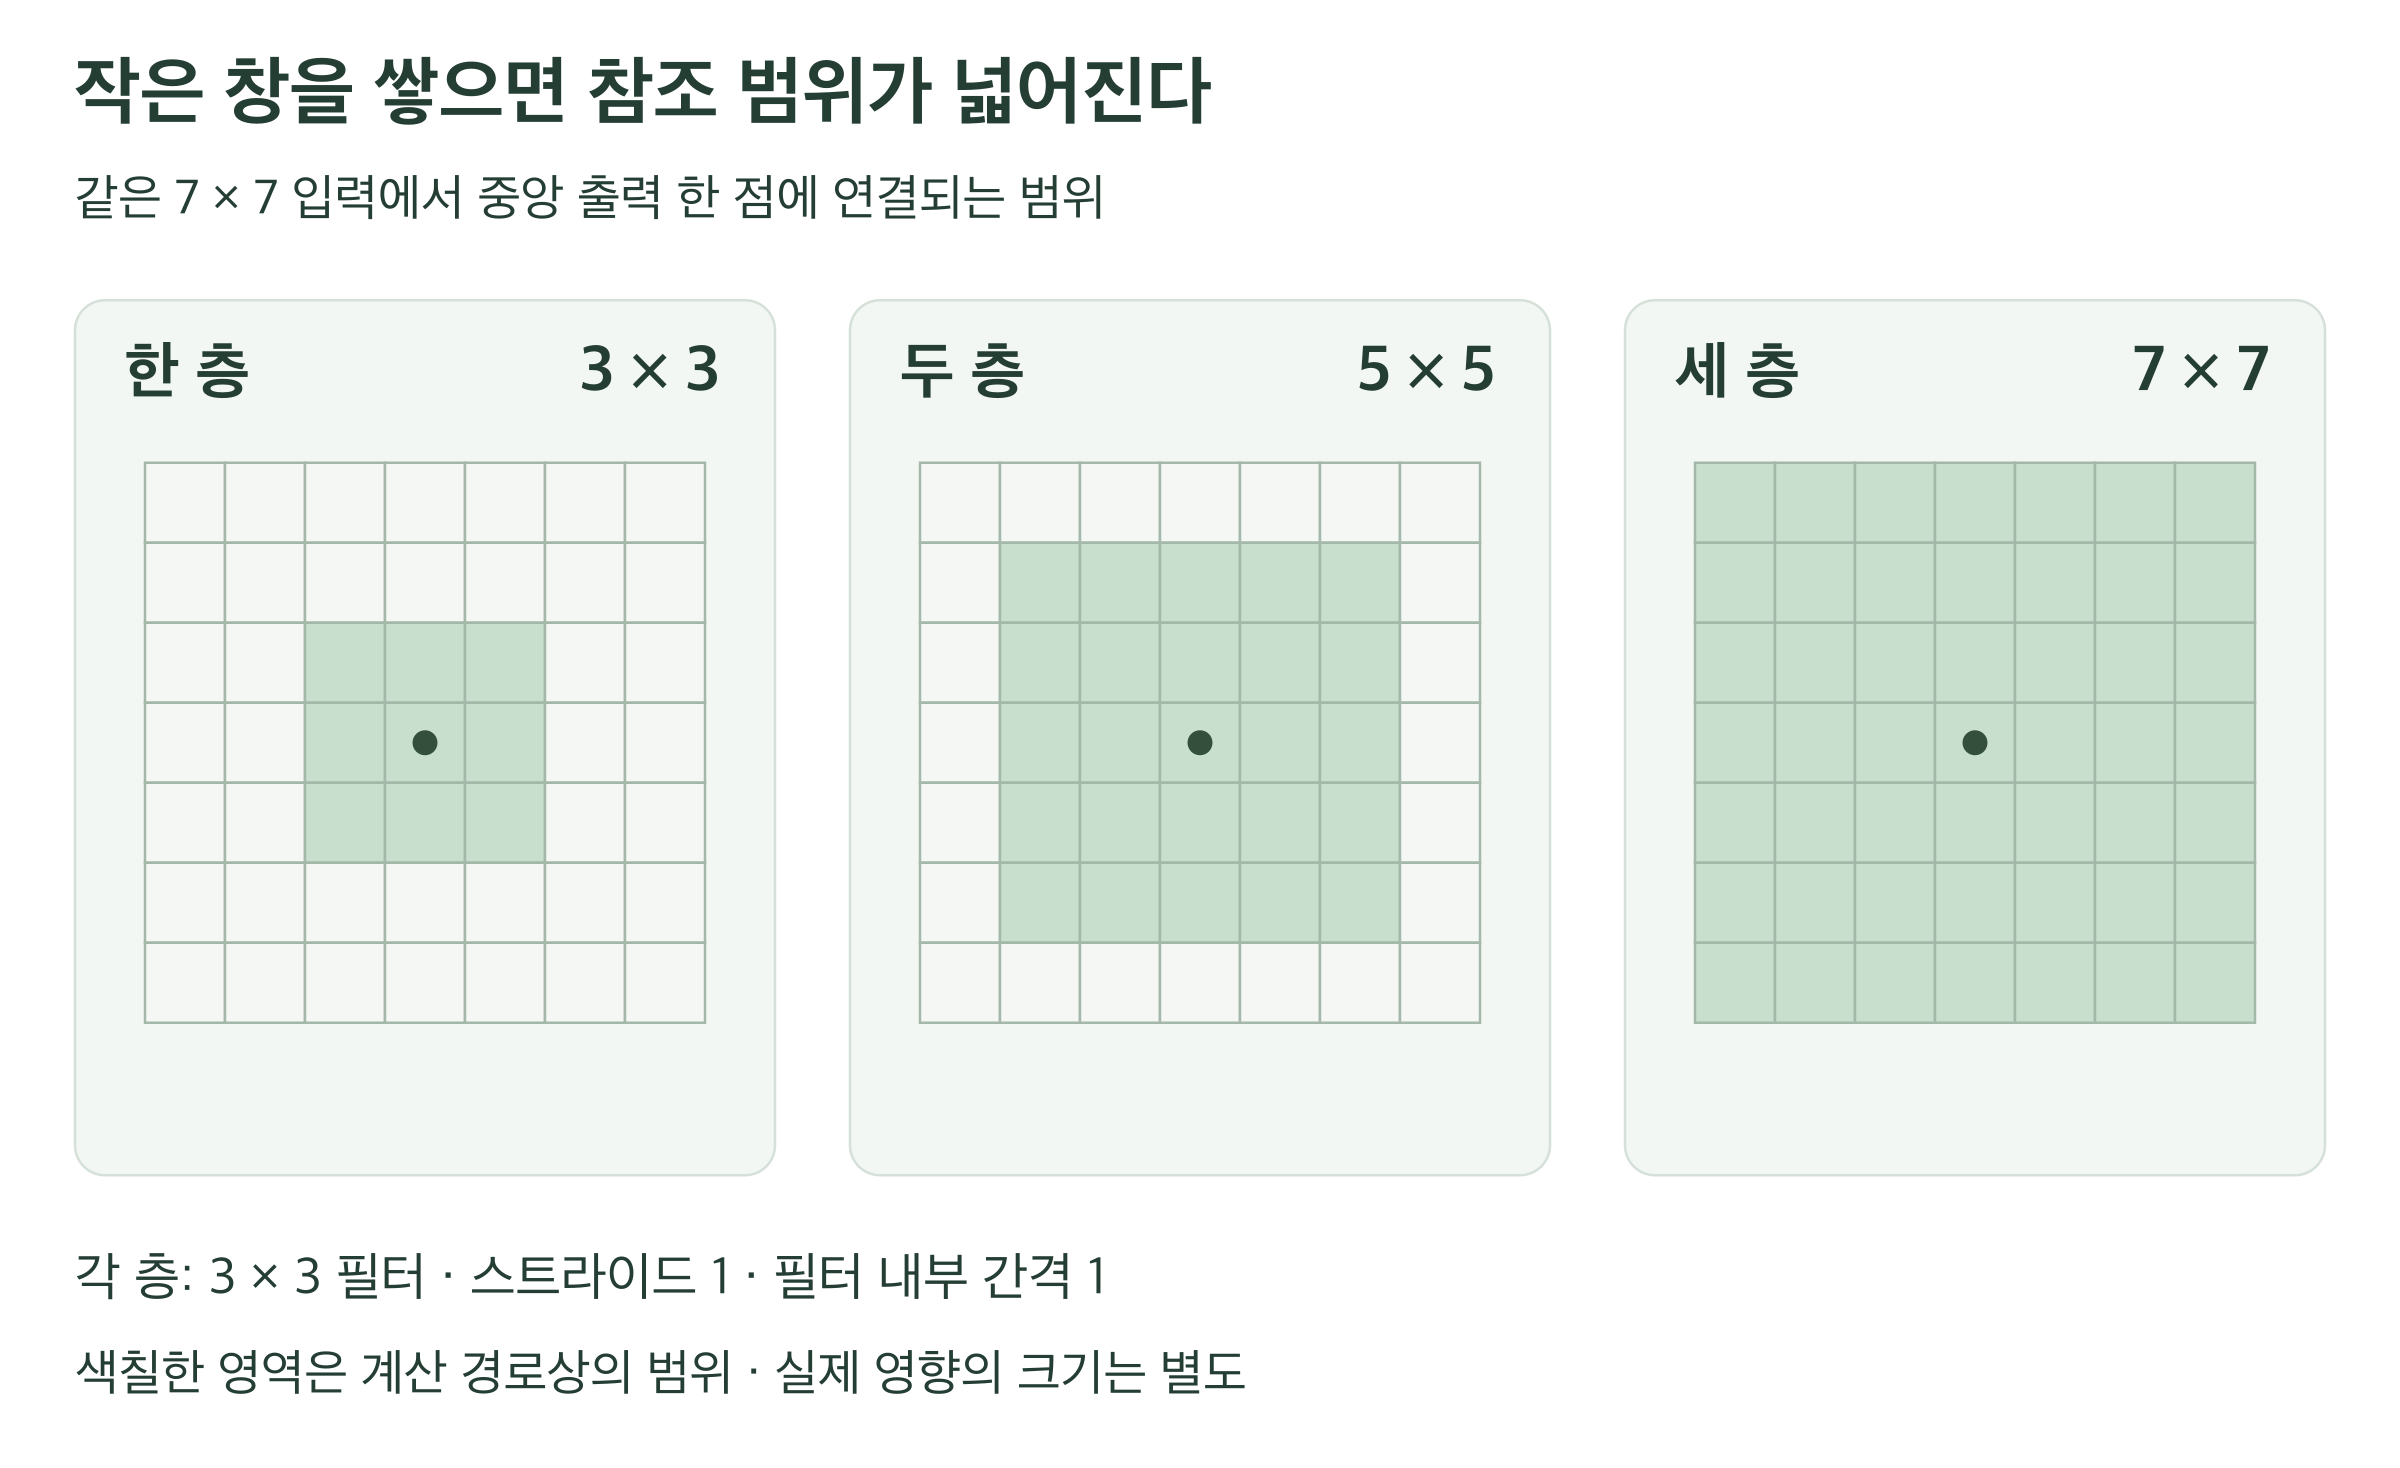
동일한 7×7 입력 격자 세 개에서 중앙 출력에 대응하는 이론적 수용영역을 비교한다. 3×3 합성곱 한 층은 3×3, 두 층은 5×5, 세 층은 7×7 범위와 연결된다. 각 층의 스트라이드와 필터 내부 간격은 1이다.
자체 계산 경로 도식. 왼쪽에서 오른쪽으로 갈수록 입력 영상이 커지는 것이 아니라, 같은 입력에서 한 출력에 연결되는 범위가 넓어진다. 그림은 앞의 2×2 필터 예와 별개의 3×3 필터 예다.
수관 윤곽의 작은 조각들이 더 넓은 수관 형태와 주변 맥락을 표현하는 데 함께 쓰일 수 있다는 직관으로 연결할 수 있다. 다만 모든 층이 반드시 ‘경계→잎→수목’처럼 사람이 정한 순서로 의미를 배운다는 뜻은 아니다. 계산 경로가 연결된 전체 범위와 실제로 크게 영향을 주는 부분도 같지 않을 수 있다. 수용영역의 계산과 영향 범위
풀링은 무엇을 남기고 줄이는가
**풀링(pooling)**은 작은 영역의 여러 값을 대표값으로 요약하는 연산이다. 최대 풀링은 가장 큰 값, 평균 풀링은 평균을 남긴다. 이동 간격을 함께 정하면 특징맵의 가로·세로 크기를 줄일 수 있다. 일반적인 최대·평균 풀링은 필터 가중치를 학습하지 않는다. D2L 최대·평균 풀링
앞의 3×3 특징맵에 2×2 최대 풀링을 한 칸씩 적용하면 네 창이 모두 320을 포함하므로 결과는 2×2의 [320, 320; 320, 320]이다. 강한 반응이 있다는 정보는 남지만 정확히 어느 열에 있었는지는 줄어든다. 앞뒤 표현이 담는 정보의 차이를 볼 수 있다.
작은 위치 변화에 덜 민감한 표현은 종류를 구별할 때 도움이 될 수 있다. 반면 가는 포장 균열이나 작은 시설물의 위치를 복원하려면 세부 정보가 필요하다. 따라서 ‘작게 줄일수록 좋다’는 원칙은 없다. 풀링을 사용하는 구조와 위치 정보를 다시 구성하는 방법은 수행할 과제에 맞추어 선택한다.
CNN이 학습한다는 것은 무엇인가
지금까지의 필터는 사람이 정했다. CNN의 학습에서는 여러 층의 가중치 등을 자료와 학습 목적에 맞게 조정한다. 예를 들어 분류 학습에서는 모델의 출력과 목표 범주의 차이를 수치화하는 **손실(loss)**을 두고, 이를 줄이는 방향으로 값을 조정한다. 계산한 결과를 거꾸로 따라가며 각 값의 변화가 손실에 미치는 영향을 구하는 과정을 **역전파(backpropagation)**라고 한다. 역전파가 구한 정보를 이용해 최적화 방법이 가중치를 갱신한다. D2L 역전파와 학습
이렇게 학습한 표현에도 조경가가 원한 단서와 원치 않은 단서가 함께 들어갈 수 있다. 수종을 구별하려던 모델이 촬영 배경에 의존할 가능성도 있다. 계절과 장소를 바꾸어 확인해야 하는 이유는 4.8–4.9에서 이어 간다. 이번 격자 계산은 학습을 수행한 결과가 아니다.
4.4 Vision Transformer와 Attention
이미지를 패치와 토큰으로 바꾸기
**Vision Transformer(ViT)**는 영상을 작은 조각의 벡터로 바꾸고 Transformer 구조로 그 관계를 처리하는 방법이다. **패치(patch)**는 나눈 영상 영역이고, **토큰(token)**은 모델이 처리하는 시퀀스의 단위다. 기본 ViT에서는 패치를 펼친 값에 학습 가능한 변환을 적용해 패치 임베딩을 만든다.
4×4 회색조 영상을 겹치지 않는 2×2 패치로 나누면 네 패치가 생긴다. 각 패치의 네 픽셀 값을 정해진 순서로 나열한 뒤 모델이 사용하는 길이의 벡터로 바꾼다. 이 변환은 패치의 평균만 남기는 풀링과 다르다. D2L 패치 임베딩의 원리
패치는 객체가 아니다. 하나의 수관이 여러 패치에 걸릴 수 있고, 한 패치에 잎·포장·그림자가 함께 들어갈 수도 있다. 패치를 만드는 단계에서 수목과 벤치를 이미 알아본 것으로 해석하면 안 된다.
패치를 일렬로 배열하더라도 원래 어디에 있었는지 알 수 있도록 위치 정보를 함께 제공한다. 원래 ViT는 학습 가능한 **위치 임베딩(position embedding)**을 패치 임베딩에 더한다. 이것은 영상 안의 배치 정보이며 GIS 좌표나 실제 높이가 자동으로 붙는다는 의미가 아니다. ViT 원 논문 §3.1
어텐션은 정보를 섞는 비중을 계산한다
**어텐션(attention)**은 현재 표현을 갱신할 때 다른 표현들의 정보를 얼마나 반영할지 계산하는 방식이다. 단순히 가장 밝은 영역이나 사람이 눈여겨볼 영역을 고르는 기능으로 이해하기보다는, 입력에 따라 달라지는 가중 결합으로 이해하는 것이 정확하다.
**자기어텐션(self-attention)**에서는 같은 시퀀스의 토큰들로부터 세 종류의 벡터를 만든다.
| 이름 | 계산에서의 역할 |
|---|---|
| Query, Q | 현재 토큰이 다른 토큰과 대응 정도를 계산할 때 사용하는 표현 |
| Key, K | 각 토큰이 그 비교에 제공하는 표현 |
| Value, V | 계산된 비중에 따라 실제로 합쳐질 정보 |
Q와 K의 대응 점수를 계산하고 크기를 조절한 뒤 **소프트맥스(softmax)**를 적용하면, 참조하는 토큰들에 대한 양의 비중을 만들 수 있다. 한 토큰에 대한 이 비중의 합은 1이다. 그 비중으로 V들을 가중합한다. Q·K·V는 사람이 작성하는 질문이나 사전 항목이 아니라 학습 가능한 변환으로 얻는 수치다. **멀티헤드 어텐션(multi-head attention)**은 서로 다른 변환으로 이러한 결합을 여러 번 계산하고 결과를 함께 사용한다. Transformer 원 논문 §3.2
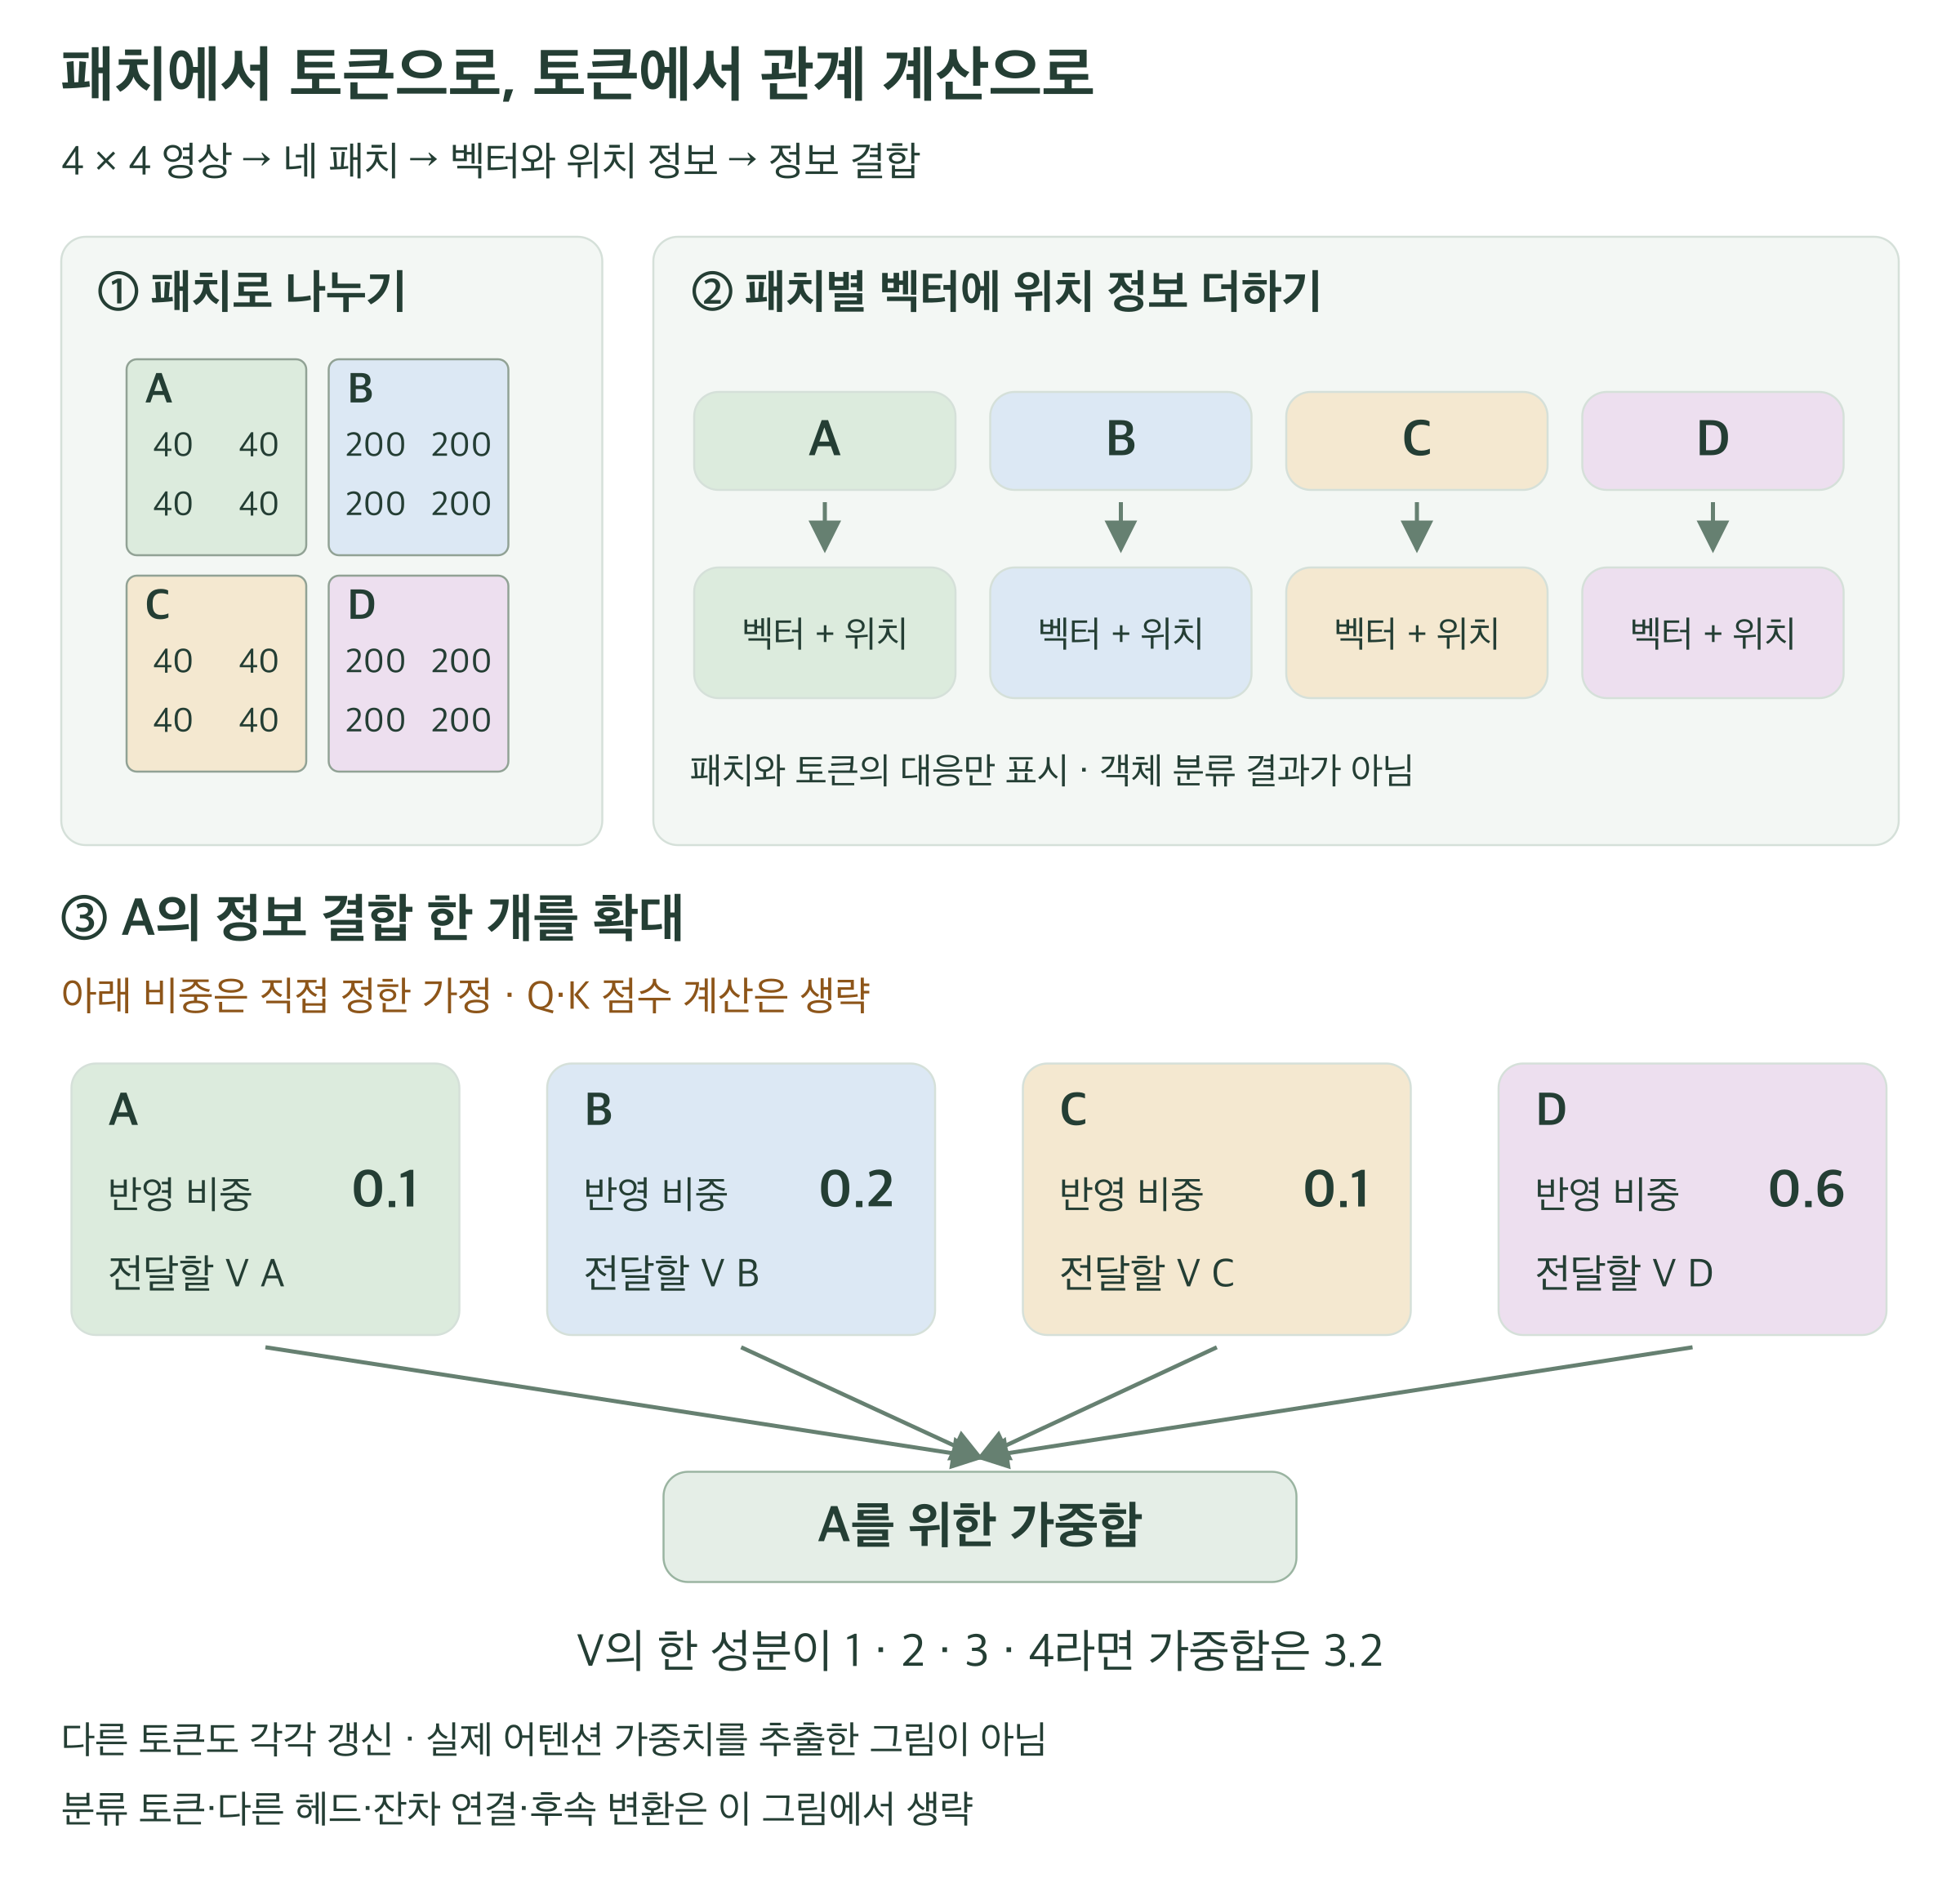
4×4 영상을 A·B·C·D의 네 패치로 나누고 각 패치의 벡터에 위치 정보를 더해 토큰으로 만든다. A를 갱신하는 한 가중합에서 A·B·C·D의 값을 각각 0.1·0.2·0.1·0.6만큼 반영한다. 비중은 설명용 가정이며 실제 학습 결과가 아니다.
자체 패치·가중합 도식. 표시한 비중은 계산의 뜻을 설명하려고 직접 정했다. 영상에서 Q·K를 구하거나 실제 어텐션을 추출한 그림이 아니다. A의 결합 하나만 확대했으며 기본 자기어텐션은 다른 토큰도 각각 갱신한다.
그림에서 A의 새 정보를 만들 때 A·B·C·D의 V에 각각 0.1·0.2·0.1·0.6을 곱해 더한다. 단순히 V의 한 성분을 1·2·3·4라고 가정하면 가중합은 3.2다. 실제 V는 여러 성분을 가지며 이러한 결합을 성분별로 수행한다. 그림의 색과 이름은 대응을 설명하는 표식이다.
D의 비중 0.6은 ‘D가 수목일 확률 60%’나 ‘D가 설계상 가장 중요함’을 뜻하지 않는다. 특정 층·헤드·토큰에서 정보를 결합하는 비중이다. 다른 입력이나 다른 토큰에서는 비중이 달라질 수 있다. 어텐션 그림만으로 모델 판단의 원인과 타당성을 모두 설명했다고 보지 않는다.
멀리 떨어진 패치도 함께 참조할 수 있다
기본 ViT의 전역 자기어텐션에서는 한 토큰이 멀리 떨어진 패치의 표현도 직접 참조할 수 있다. 조경 장면에서는 수관 일부의 모양뿐 아니라 떨어진 곳의 식생·포장·시설 배치를 함께 사용하는 가능성과 연결된다. 그렇다고 모델이 공원의 기능이나 설계 의도를 저절로 이해하는 것은 아니다.
관계 계산 뒤에는 각 토큰의 값을 다시 변환하는 신경망이 이어진다. 잔차 연결은 앞의 표현을 뒤의 계산 결과에 더해 전달하고, 정규화 층은 중간 값의 규모를 조절한다. 기본 ViT는 이런 블록을 반복한다. 영상 분류용 원래 구조에서는 별도의 분류 토큰을 추가하고 그 최종 표현으로 범주를 계산한다. 그림은 패치 연결에 집중하여 이 토큰과 나머지 블록을 생략했다. ViT의 인코더와 분류 표현
패치 크기와 계산량
패치를 쓰는 이유에는 계산할 단위의 수를 줄이는 효과도 있다. 영상 가로·세로가 그대로일 때 패치의 한 변을 절반으로 하면 패치 수는 네 배가 된다. 모든 토큰 쌍을 비교하는 기본 방식에서는 비교할 쌍의 수가 토큰 수의 제곱에 따라 증가한다. 영상 속 작은 대상을 얼마나 잘 표현할지와 계산 부담을 함께 고려해야 한다.
위 4×4 예에서 2×2 패치는 네 개이므로 패치 토큰끼리 비교하는 쌍은 자기 자신을 포함해 16개다. 1×1로 나누면 토큰은 16개, 쌍은 256개다. 이는 한 헤드의 패치 토큰 쌍 수를 센 설명용 산술이다. 분류 토큰을 넣거나 다른 연산을 포함한 전체 실행시간·메모리가 정확히 16배라는 뜻은 아니다.
패치를 작게 만든다고 항상 인식이 좋아지는 것도 아니다. 입력에 대상의 세부가 남아 있는지, 어떤 표현을 학습했는지, 모델이 어떤 해상도와 구조로 준비되었는지를 함께 보아야 한다. 전역 어텐션 외의 변형은 여기서 나열하지 않고 기본 원리의 범위를 분명히 한다.
CNN과 ViT를 조경가의 관점에서 비교하기
| 비교할 점 | 기본 CNN | 기본 ViT |
|---|---|---|
| 출발하는 계산 | 이웃 영역에 같은 필터를 적용 | 패치 벡터에 위치 정보를 더함 |
| 공간 정보를 연결하는 방식 | 층을 쌓으며 참조 범위를 넓힘 | 토큰 간 비중으로 정보를 결합 |
| 구조에 들어 있는 가정 | 국소 패턴과 위치 간 규칙 공유 | 패치 단위 표현과 관계 계산 |
| 작은 대상에서 살필 점 | 입력 해상도와 다운샘플링에서 남는 정보 | 입력 해상도와 패치화·표현에서 남는 정보 |
| 성능을 판단할 근거 | 과제·자료·평가 조건 | 과제·자료·평가 조건 |
이 비교는 기본 구조의 설명이다. CNN도 넓은 맥락을 사용할 수 있고, 실제 모델에는 합성곱과 어텐션을 결합한 구조도 있다. ‘ViT이므로 우수하다’거나 ‘CNN이므로 작은 자료에 항상 유리하다’고 결정할 수 없다. 구조에 미리 넣은 가정과 자료에서 배우는 관계의 차이가 핵심이다. ViT 원 논문의 구조 가정과 혼합 방식
CNN과 ViT는 표현을 만드는 구조이고, 분류·탐지·분할은 얻으려는 결과의 종류다. 같은 계열의 표현을 서로 다른 출력 구조와 학습 목적에 연결할 수 있다. 다음 단위에서는 무엇이 있는지, 어디에 있는지, 어떤 영역을 차지하는지, 시간에 따라 무엇과 대응하는지를 다섯 과제로 나누어 설명한다.
자체 계산 자료: 필터·풀링·수용영역·패치와 가중합. 계산 예와 도식은 직접 구성했다. 외부 논문의 그림과 코드를 재현하지 않았으며 CNN·ViT 학습이나 실제 공원 영상의 추론은 수행하지 않았다.
3단위. 컴퓨터 비전의 주요 과제
4장 3단위 · v0.1 검토용 초고
4.5 컴퓨터 비전의 주요 과제
공원 사진 한 장을 보고 “나무가 있다”고 말하는 것과 나무마다 경계를 그리는 것은 다른 일이다. 사진 여러 장에서 같은 작업 장비를 계속 찾아내는 일에는 시간에 따른 대응도 필요하다. 컴퓨터 비전에서 **과제(task)**란 입력 자료로부터 어떤 형태의 답을 만들어야 하는지를 정한 문제다. 과제를 정하면 필요한 학습자료, 모델의 출력, 결과를 확인할 기준도 달라진다.
앞 절의 CNN과 ViT는 특징과 표현을 계산하는 구조였다. 여기서는 그 표현을 어떤 답으로 바꾸는지 살펴본다. 같은 구조를 활용하더라도 마지막 출력과 학습 목표를 다르게 구성하면 영상에 이름을 붙이거나, 물체를 상자로 표시하거나, 픽셀마다 범주를 부여할 수 있다. 따라서 “어떤 AI를 사용할까”에 앞서 조경 업무에 필요한 답의 단위를 정해야 한다. TorchVision도 분류·탐지·분할 등을 별도 과제로 구분하여 모델과 사용법을 제시한다. TorchVision 과제별 모델 안내
범주·위치·영역·개체·시간적 대응
이 절에서는 대표적인 다섯 과제를 구분한다. 컴퓨터 비전 전체를 다섯 가지로 한정하는 분류는 아니다.
| 과제 | 답을 부여하는 단위 | 대표 출력 | 조경에서 던질 질문 |
|---|---|---|---|
| 분류 · classification | 영상 전체 또는 잘라낸 영역 | 범주 이름과 점수 | 이 포장 부분은 어떤 종류인가? |
| 탐지 · object detection | 영상 속 객체 후보 | 범주, 경계 상자, 점수 | 벤치가 어느 위치에 보이는가? |
| 의미 분할 · semantic segmentation | 픽셀 | 픽셀별 범주 지도 | 잔디·포장·수관은 각각 어느 영역인가? |
| 개체 분할 · instance segmentation | 개별 객체와 그 픽셀 | 개체별 마스크와 범주 | 서로 맞닿은 수관을 각각 구별할 수 있는가? |
| 추적 · tracking | 시간에 따른 같은 대상의 관측 | 프레임별 위치와 연결된 추적 ID | 앞선 영상의 장비가 다음 영상에서는 어디에 있는가? |
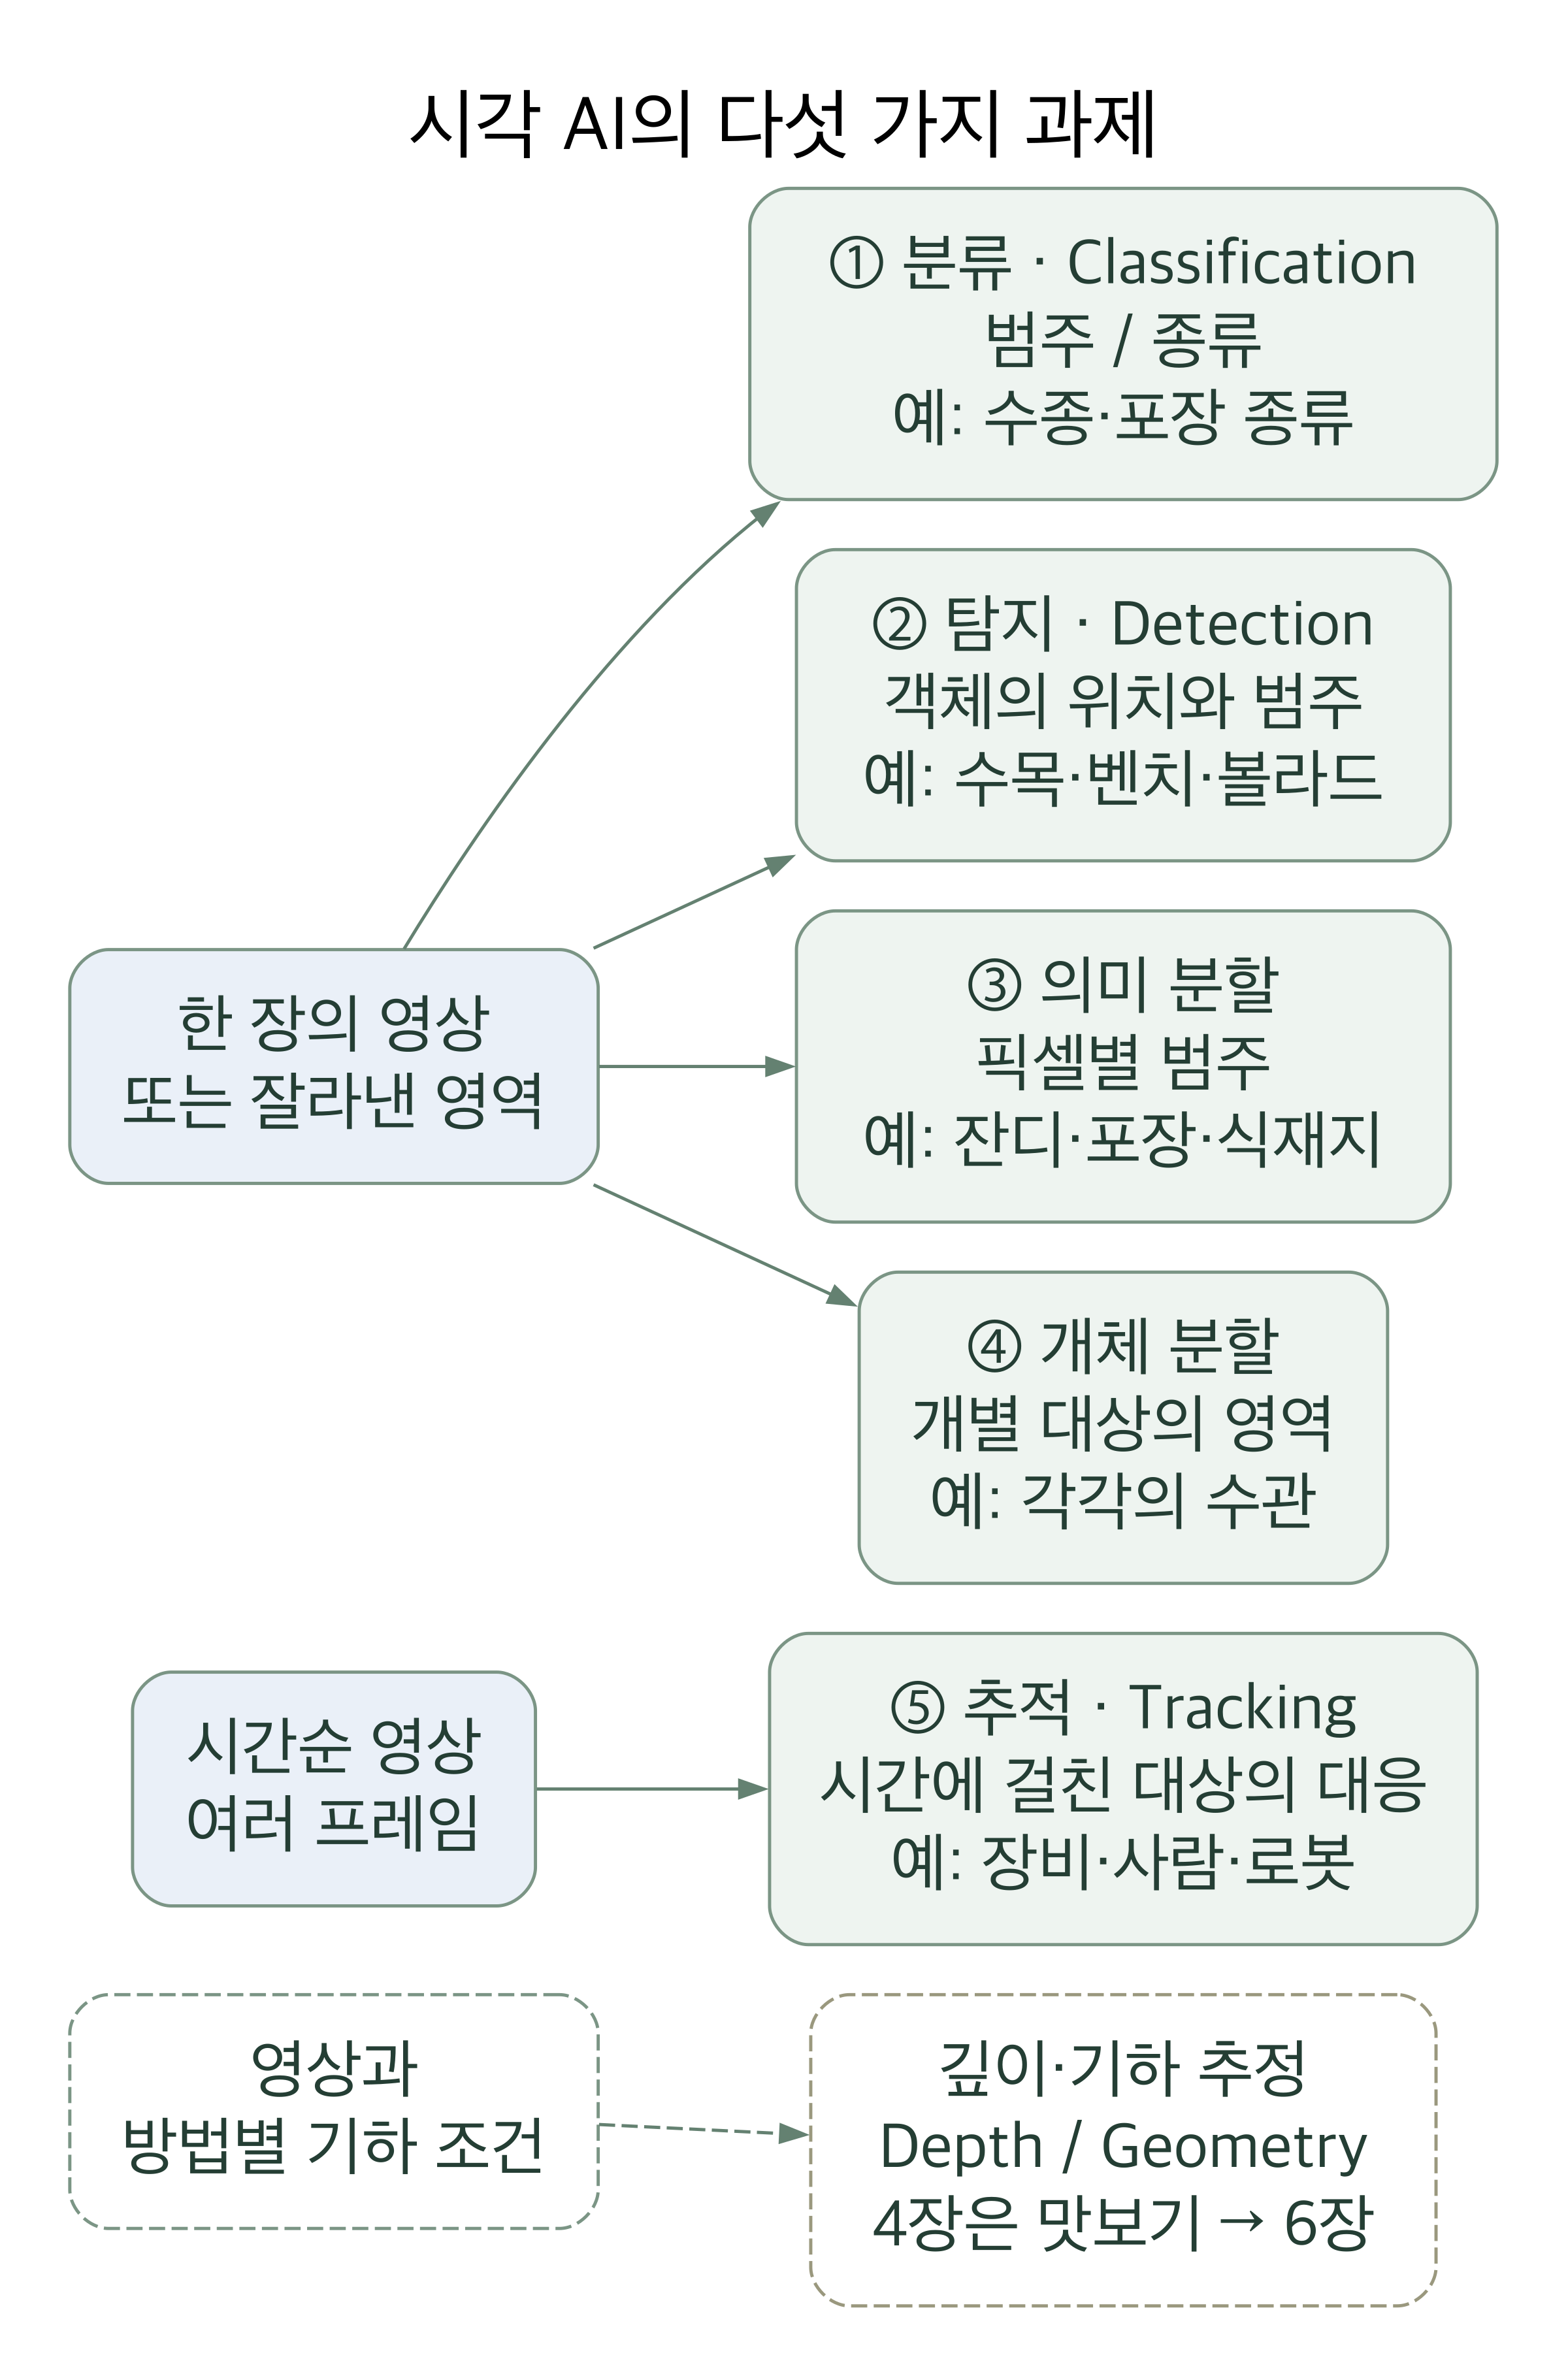
한 장의 영상 또는 영역은 분류·탐지·의미 분할·개체 분할에 연결된다. 시간순 영상은 추적에 연결되고 깊이·기하는 별도 과제로 6장에 이어진다.
그림. 입력과 필요한 출력으로 구별한 시각 AI의 과제. 자체 도식이다. 화살표는 입력의 연결이며, 다섯 과제를 순서대로 수행해야 한다는 뜻이 아니다. 실제 시스템에서는 탐지 결과를 추적에 활용하는 등 과제를 결합한다.
분류: 정해진 단위에 이름 붙이기
분류는 입력을 미리 정한 범주 중 어디에 속하는지 판단하는 과제다. 공원 장면 전체를 ‘수림 중심 공간’으로 분류할 수도 있고, 포장만 잘라낸 작은 영상을 ‘판석포장’으로 분류할 수도 있다. 무엇을 하나의 입력으로 삼았는지에 따라 같은 범주 이름의 의미도 달라진다. 한 입력에 하나의 범주를 부여하는 방식과, ‘수목 있음·포장 있음’처럼 여러 범주의 존재를 함께 판단하는 방식도 구별한다.
가상 공원의 사진에서 판석포장 부분을 잘라 분류했다고 하자. 출력이 ‘판석포장’이면 해당 입력의 종류를 설명할 수 있다. 하지만 이 결과에는 원래 사진의 어느 픽셀이 판석인지, 판석이 몇 장인지, 시공 면적이 몇 제곱미터인지가 들어 있지 않다. 사진을 잘라낸 위치를 함께 보관하면 분류 결과를 원 영상의 영역에 연결할 수 있지만, 그것만으로 포장 경계를 얻는 것은 아니다.
지도학습으로 이 과제를 준비한다면 보통 입력 영상과 범주를 짝지은 자료가 필요하다. 이때 **라벨(label)**은 사람이 정한 기준에 따라 자료에 부여한 이름이나 값이다. ‘잔디’, ‘초본 식재지’, ‘수관’의 구별 기준이 불명확하면 모델이 배워야 할 차이도 흔들린다. 범주 체계를 먼저 정의하는 일은 조경 지식을 데이터에 반영하는 첫 단계다.
탐지: 객체 후보의 위치를 상자로 표시하기
객체 탐지는 영상에 나타난 대상의 범주와 위치를 함께 예측하는 과제다. 흔히 **경계 상자(bounding box)**라는 사각형으로 위치를 표시한다. 상자는 ‘이 범위에 수목 후보가 있다’는 결과이며, 수관의 굴곡을 따라 그린 경계는 아니다. 한 상자에는 대상과 함께 배경이 들어갈 수 있다. TorchVision의 객체 탐지 예제에서도 상자 좌표와 범주를 별도 자료로 다룬다. TorchVision 탐지·개체 분할 안내
상자를 저장할 때에는 좌표의 뜻까지 정해야 한다. 예를 들어 왼쪽 위 모서리를 원점으로 두고 가로를 x, 세로를 y로 표시할 수 있다. 아래는 설명을 위해 정한 8×6 픽셀 격자의 한 수관 후보이다.
| 항목 | 설명용 값 | 값의 의미 |
|---|---|---|
| 범주 | 수관 | 영상에서 찾도록 정한 대상 |
| 상자 | (1, 1, 4, 4) | 왼쪽·위쪽 경계와 오른쪽·아래쪽 경계 |
| 상자 안 픽셀 수 | 3×3 = 9 | 이 예에서는 오른쪽·아래쪽 경계를 포함하지 않음 |
| 수관으로 표시한 픽셀 수 | 6 | 아래 분할 그림에서 같은 후보에 부여한 영역 |
상자 면적 9와 수관 마스크 면적 6은 서로 다르다. 좌표 저장 형식도 도구마다 다를 수 있으므로, 숫자 네 개만 넘기지 않고 좌표 순서와 단위를 남겨야 한다. 여기의 좌표는 영상 좌표다. 2장에서 다룬 국가 좌표계의 미터 좌표와 연결하려면 별도의 위치 대응이 필요하다.
검토를 거친 탐지 결과는 영상 속 객체 목록을 만드는 출발점이 된다. 그러나 상자가 열 개 출력되었다고 실제 수목이 열 주 있다고 확정할 수는 없다. 같은 수목에 상자가 중복되거나, 그늘을 수목으로 잘못 찾거나, 가려진 수목을 놓칠 수 있기 때문이다. 수량 집계의 신뢰도는 이런 오류를 확인한 범위 안에서 해석한다.
의미 분할: 픽셀마다 무엇인지 표시하기
의미 분할은 각 픽셀에 범주를 부여하여 영상의 영역을 구분하는 과제다. 공원 영상의 픽셀을 ‘수관’, ‘잔디’, ‘초본 식재지’, ‘판석포장’, ‘그 밖의 영역’으로 나누면 범주별 분포를 살펴볼 수 있다. 이 결과에서 같은 수관 범주의 픽셀은 어느 나무에 속하든 같은 범주 값을 가진다. 개별 나무를 구별하는 번호까지 주는 것은 의미 분할의 기본 목표에 포함되지 않는다. D2L 분할 개념
**마스크(mask)**는 특정 영역의 포함 여부나 범주 값을 픽셀별로 저장한 자료다. 한 범주만 표시하는 이진 마스크에서는 해당 영역을 1, 나머지를 0으로 둘 수 있다. 여러 범주를 저장한다면 범주별 정수 코드를 사용할 수도 있다. 화면의 초록색·파란색은 이런 값을 사람이 알아보기 쉽게 바꾼 범례이지, 원 영상에서 측정한 색이 아니다.
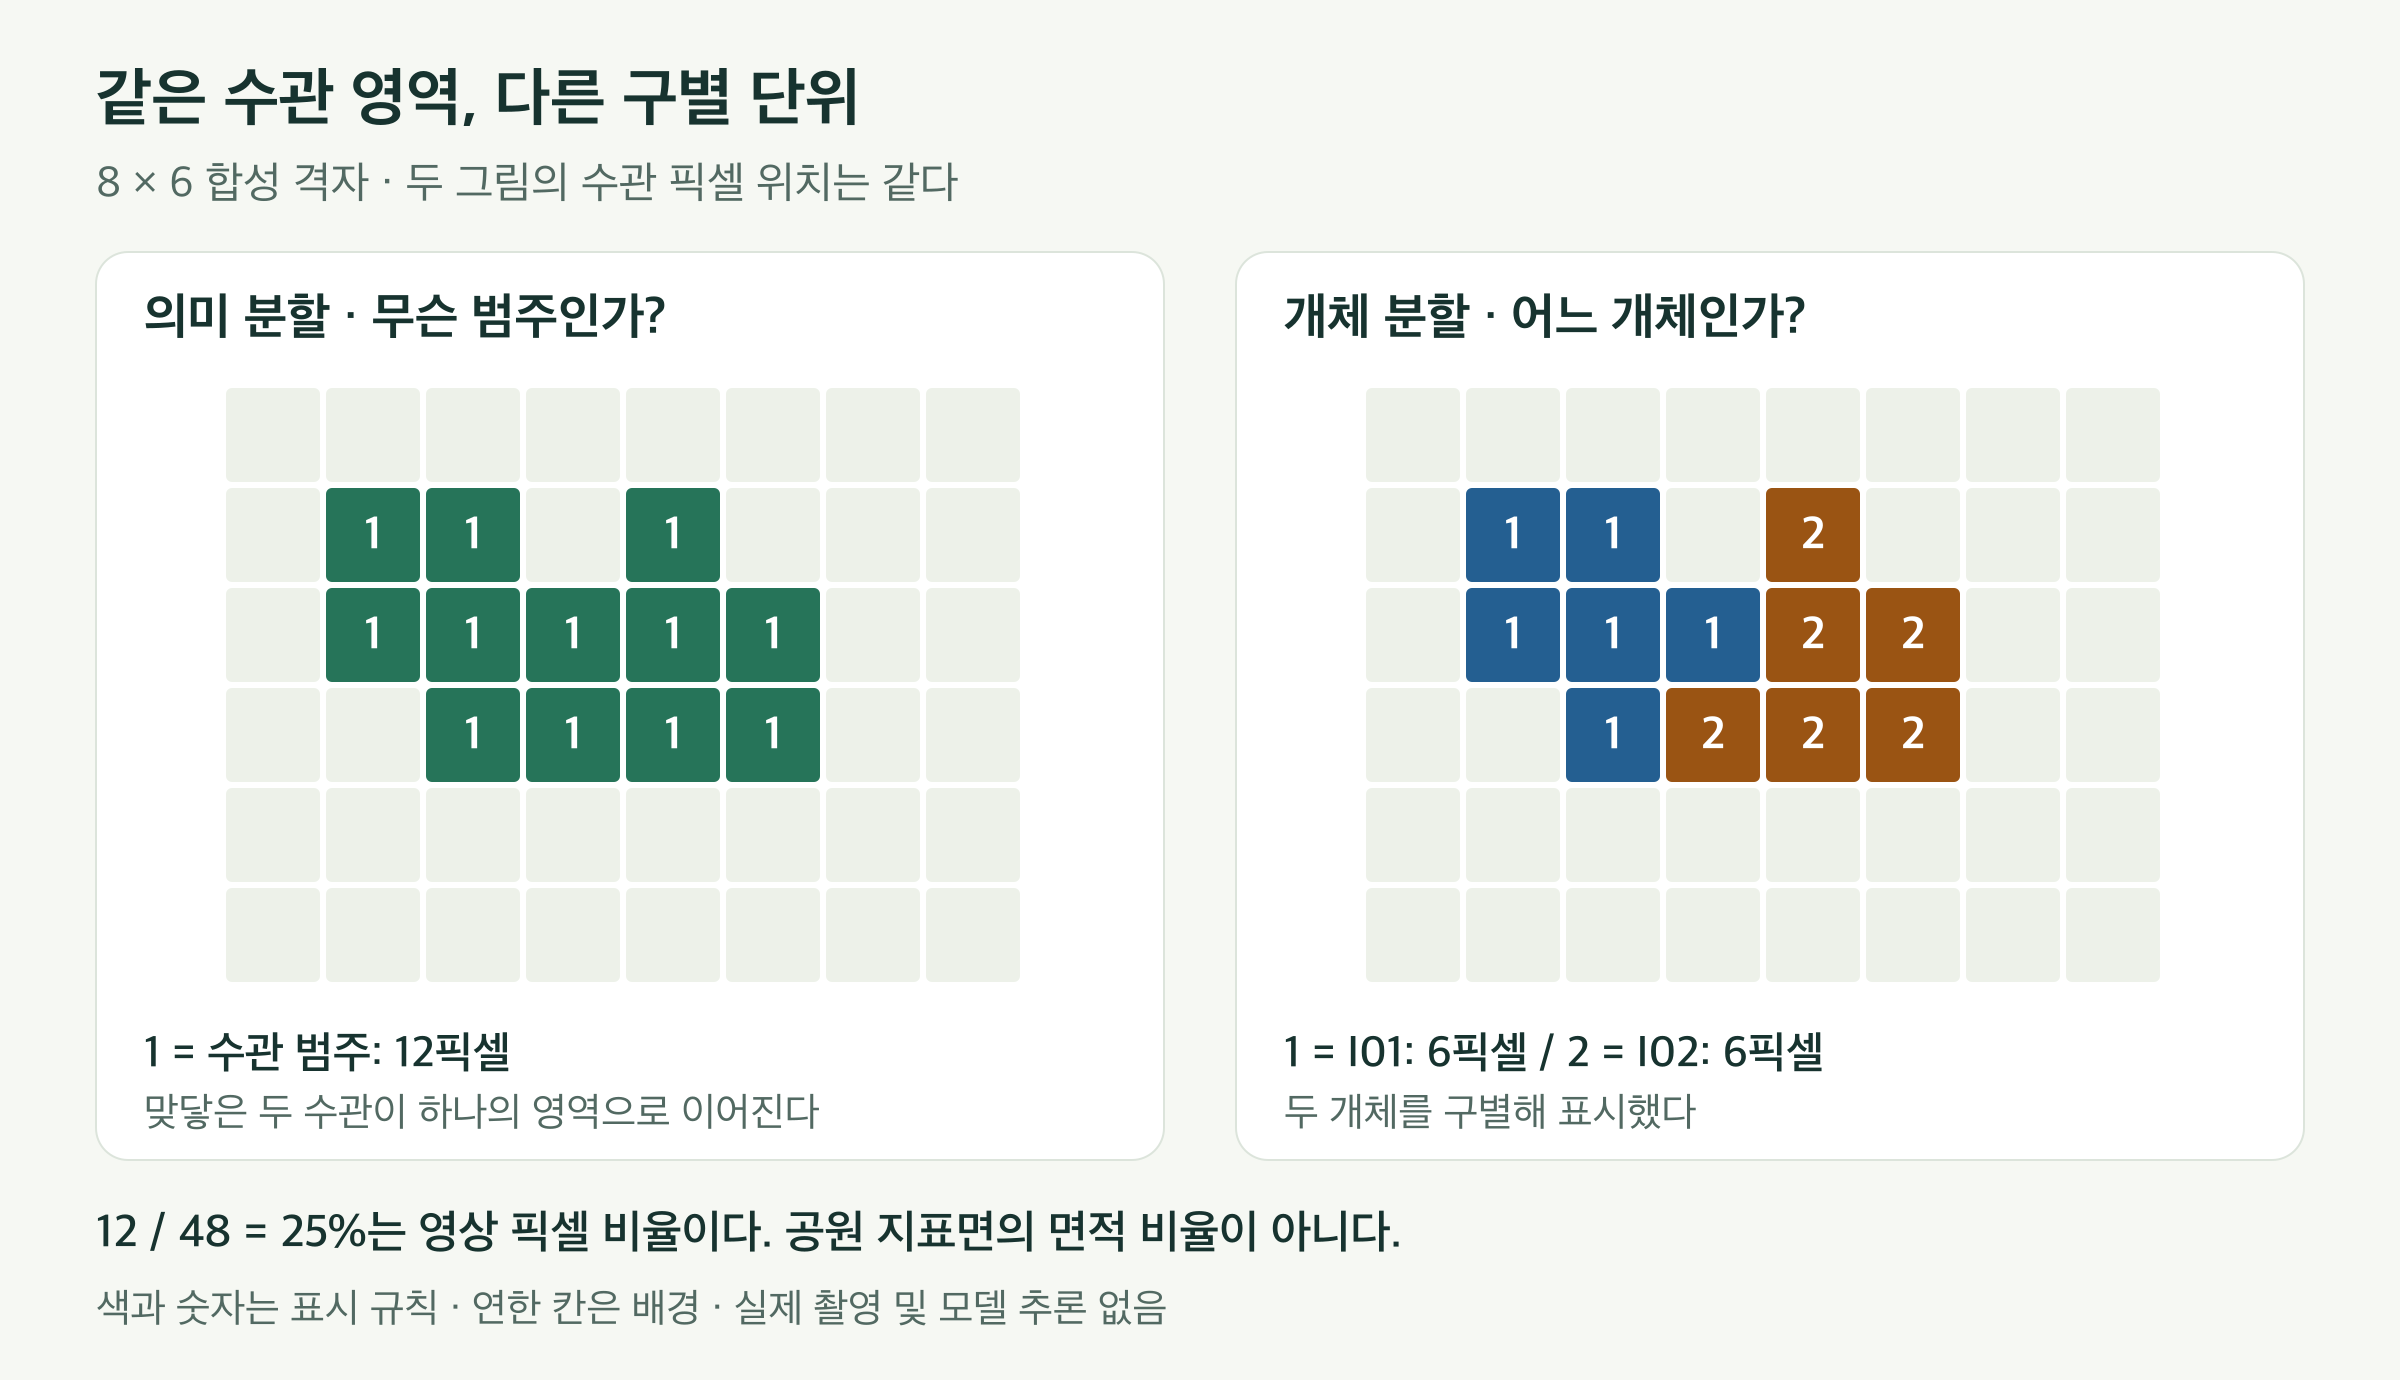
같은 8×6 격자의 수관 픽셀 12개를 비교한다. 의미 분할에서는 모두 수관 범주 1이고, 개체 분할에서는 맞닿은 두 수관이 각각 I01과 I02로 구분되어 6개씩 표시된다.
그림. 범주로 묶는 것과 개체를 나누는 것의 차이. 자체 합성 격자로, 실제 촬영이나 모델 추론 결과가 아니다. 숫자와 색은 왼쪽에서 범주, 오른쪽에서 개체를 구별한다. 두 그림의 수관 픽셀 위치는 같다.
그림의 전체 48픽셀 중 수관으로 표시한 것은 12픽셀이므로 **영상에서 차지하는 픽셀 비율은 25%**다. 이 비율은 공원 전체의 수관 피복률을 측정한 값이 아니다. 비스듬히 찍은 영상에서는 같은 픽셀 수라도 실제 면적이 다르고, 수관이 가린 지표면은 보이지 않는다. 적절히 정사보정한 자료에서 해상도·대상 범위·가림과 분류 오류를 확인해야 지도상 면적과 연결할 수 있다.
개체 분할: 같은 종류 안에서 각각을 구별하기
개체 분할은 객체마다 영역을 나누고 범주를 부여하는 과제다. 분할 비교 그림의 오른쪽에서는 두 수관을 각각 I01, I02로 구분했다. 범주는 둘 다 수관이지만 포함된 픽셀은 서로 다른 개체에 연결된다. 이 예의 개체별 마스크는 각각 6픽셀이다.
왼쪽의 수관 영역은 변을 공유하며 하나로 연결되어 있다. 따라서 같은 범주의 연결된 덩어리를 세는 것만으로는 오른쪽의 두 개체를 복원할 수 없다. 반대로 가지나 그림자로 한 수관이 여러 덩어리처럼 보일 수도 있다. 연결된 영역의 수와 개체 수는 서로 다른 정보다. 개체를 나누려면 경계·형태·맥락 등 추가 단서와 개체 구분 기준이 필요하다.
대표적인 방법인 Mask R-CNN은 객체 탐지에 개체별 마스크를 예측하는 부분을 결합했다. 이처럼 위치와 범주에 더해 객체의 영역을 출력하는 방법이 사용되어 왔다. 여기서는 구조의 역할만 소개하며 원 논문의 그림이나 성능 수치를 옮기지 않는다. Mask R-CNN 원 논문 초록
조경에서 개체 분할의 대상을 정할 때에는 ‘수목 한 주’와 ‘영상에 보이는 수관 영역’을 구별해야 한다. 수관이 겹치거나 줄기가 보이지 않으면 영상만으로 실제 개체 경계를 결정하기 어렵다. 보이는 영역을 표시하는지, 가려진 부분까지 추정하는지도 서로 다른 목표다. 이 절의 마스크는 보이는 영역을 설명하기 위한 것이며, 뿌리나 가려진 수관을 복원하지 않는다.
또한 I01은 이 영상 안에서 구별하려고 붙인 번호다. 다음 촬영에서도 자동으로 같은 번호가 유지되거나, 3장의 BIM 객체 ID와 곧바로 같아지는 것은 아니다. 현장의 수목과 연결하려면 촬영 시점·위치·기존 객체 정보 등을 대조한 대응 기록이 있어야 한다.
추적: 시간에 따라 같은 관측 대상을 연결하기
추적은 시간순 영상에서 같은 대상의 관측을 연결하고 위치 변화를 기록하는 과제다. 동영상의 한 시점 영상을 **프레임(frame)**이라 부른다. 각 프레임에서 장비를 찾아내는 탐지와, 앞 프레임의 장비가 다음 프레임의 어느 장비인지를 연결하는 일은 구별된다. 여러 대상을 동시에 다루는 경우에는 다중 객체 추적이라고 한다.
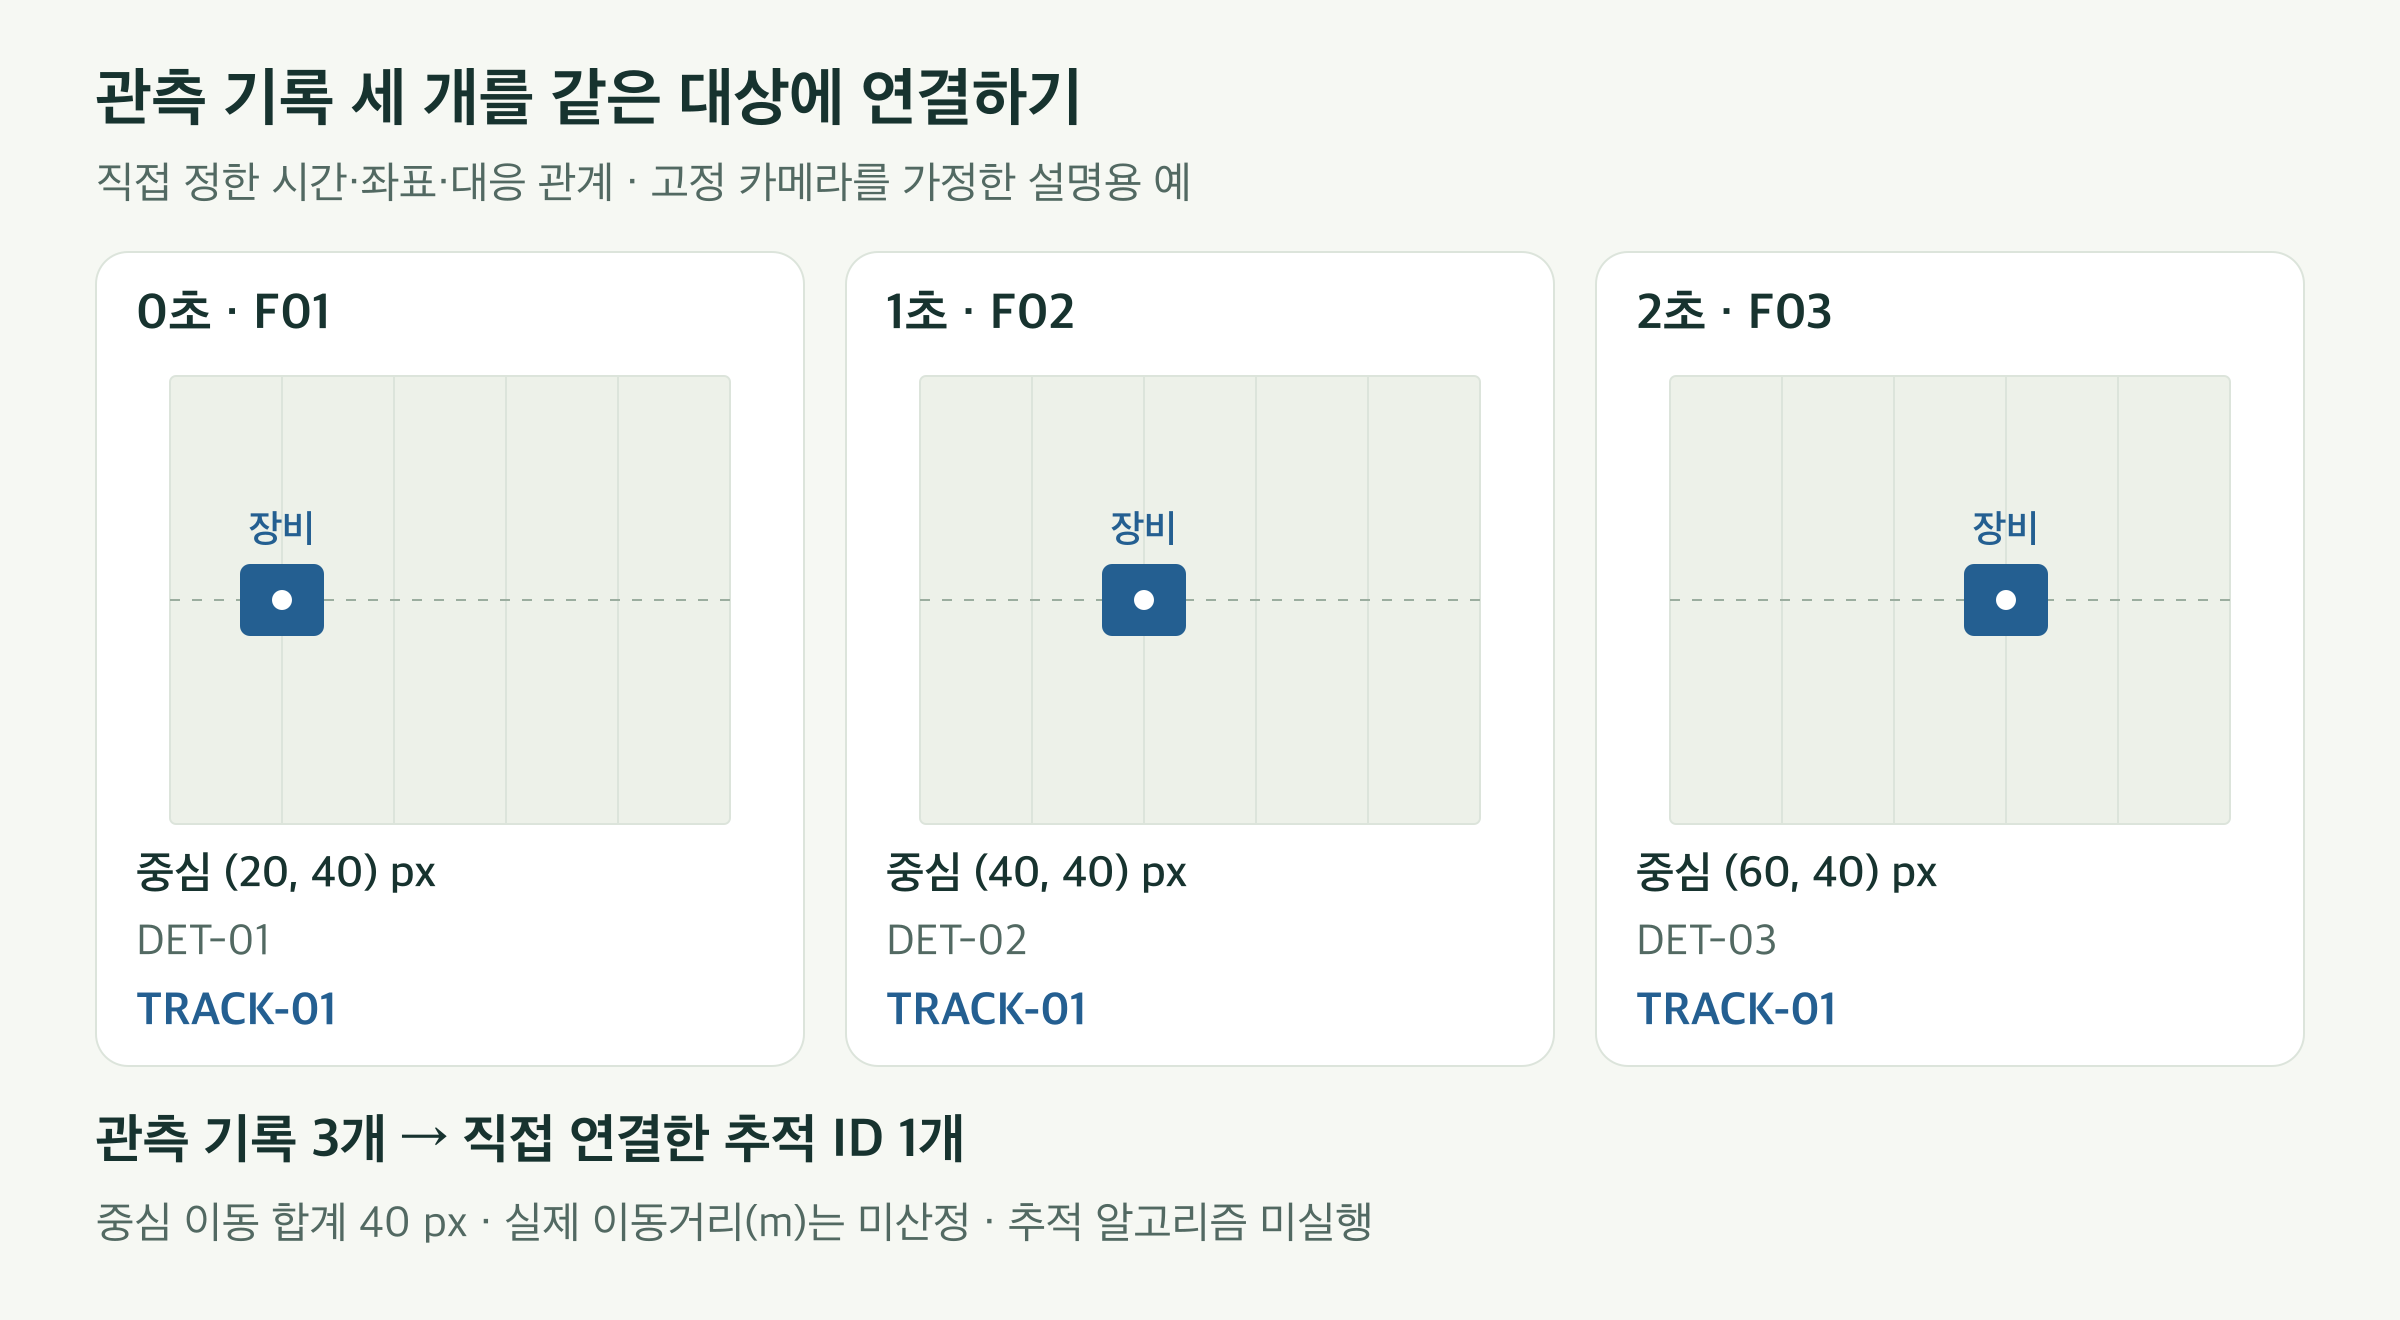
0초, 1초, 2초의 세 설명용 프레임에서 장비 후보 중심이 x좌표 20, 40, 60픽셀로 이동한다. 서로 다른 탐지 기록 세 개를 같은 TRACK-01에 연결하여 관측 기록 수 3과 추적 대상 수 1을 구분한다.
그림. 세 번 관측한 장비와 세 대의 장비는 다르다. 위치와 ID 연결을 직접 정한 자체 예이며 추적 알고리즘을 실행한 결과가 아니다. 각 프레임은 같은 100×80 픽셀 좌표계를 사용한다.
가상의 고정 카메라가 공원 작업 장비를 세 번 관측했다고 하자. 설명용 중심 좌표는 (20, 40), (40, 40), (60, 40)이고 시각은 0초, 1초, 2초다. 탐지 기록에는 각각 DET-01, DET-02, DET-03을 붙이고, 같은 장비의 관측이라는 대응을 TRACK-01로 연결했다. 저장된 관측 행은 세 개지만 이 예에서 부여한 추적 ID는 하나다. 행 수를 그대로 장비 대수로 집계하면 세 배로 세게 된다.
추적에서는 위치의 연속성, 외형의 유사성, 이동 예측 등을 이용해 대응을 추정할 수 있다. ByteTrack은 낮은 탐지 점수 때문에 버려질 수 있는 관측도 기존 추적 기록과 대응시키는 방법을 제시했다. 가림 등으로 약해진 관측을 어떻게 연결할 것인지 보여주는 방법 사례다. 특정 조경 현장에서 성능을 확인했다는 뜻은 아니다. ByteTrack 원 논문 초록
수목 뒤로 장비가 가려지면 그 프레임에서 관측이 없을 수 있다. 이를 즉시 ‘장비가 현장을 떠났다’고 기록하면 잘못된 집계가 된다. 비슷한 장비 두 대가 교차할 때는 서로의 번호가 바뀌는 **ID 전환(ID switch)**이 생길 수도 있다. 추적 ID는 알고리즘이 유지하는 대응 가설이며 실제 자산의 등록번호나 사람의 신원을 보증하지 않는다.
그림의 중심 이동은 두 구간을 합하여 40픽셀이다. 이를 40m라고 읽을 수 없고, 실제 속도나 장비와 사람 사이 안전거리로 바로 바꿀 수도 없다. 카메라 움직임, 원근, 시간 정보와 좌표 대응을 확인해야 한다. 추적은 동선 분석에 필요한 시간 기록을 제공하지만, 작업 구역의 통행 가능성이나 안전 판정을 스스로 완성하지는 않는다.
추적 중 부여한 번호와 BIM의 영구 객체 ID는 역할이 다르다. 촬영이 끊기거나 재탐지가 일어나면 추적 번호가 달라질 수 있으므로, 설계 객체에 연결하려면 7장의 대응과 확인 절차가 더 필요하다.
출력의 형태가 후속 분석을 결정한다
가상 공원의 판석포장 종류를 영상 목록에서 찾고 싶다면 분류부터 검토할 수 있다. 시설물 후보의 위치 목록이 필요하면 탐지, 피복의 영상 내 분포가 필요하면 의미 분할, 개별 수관의 보이는 경계를 비교하려면 개체 분할이 적합한 출발점이다. 작업 장비의 이동을 살펴보려면 여러 시점의 기록과 추적이 필요하다. 경계를 더 세밀하게 그린다는 이유만으로 모든 업무에서 더 나은 과제가 되는 것은 아니다.
결과를 자동으로 집계하려면 출력과 함께 해석 조건도 남겨야 한다. 예를 들어 수관 마스크에는 원 영상 ID, 범주 정의, 표시한 영역의 기준, 좌표 단위가 필요하다. 추적 기록에는 영상 시퀀스 ID와 시각이 추가된다. 모델 결과라면 모델·처리 버전과 점수도 기록할 수 있지만, 점수는 결과의 참을 보증하는 값이 아니다. 실제 성능을 확인하는 방법은 4.9, 불확실한 결과를 처리하는 기준은 4.10에서 이어간다.
깊이 추정은 픽셀의 범주와 별도로 거리나 공간 구조를 추정하는 과제다. 분할을 마쳤다고 깊이가 저절로 생기지는 않는다. 관측 조건과 공간표현에 대한 설명은 6장으로 넘긴다. 이제 필요한 출력의 형태를 구별했으므로, 다음 단위에서는 이미 학습된 시각 표현을 재사용하는 기반모델과 영상·언어 모델을 살펴본다.
이 단위의 격자·좌표·ID는 설명을 위해 직접 만든 자료다. 실제 공원 영상, 수목 목록, 모델 예측이나 측량 결과가 아니다. 출처와 실제 열람 범위는 별도로 기록했다.
4단위. 기반모델과 영상·언어 연결
4장 4단위 · 4.6–4.7 · v0.1 검토용 초고
가상 공원의 현황 사진에서 판석포장과 초본 식재지를 구분하려면, 조경 사진을 대량으로 모아 모델을 처음부터 학습시켜야 할까? 앞 절에서 배운 과제마다 새 모델을 만드는 방법도 있지만, 다른 자료에서 이미 학습한 표현을 가져와 활용할 수도 있다. 이때 핵심은 모델의 이름보다 무엇을 재사용하고, 무엇을 우리 자료에 맞추며, 어떤 출력을 확인할 것인가에 있다.
4.6 시각 기반모델: 이미 배운 표현을 활용하기
사전학습 모델과 기반모델
**사전학습(pretraining)**은 이후의 활용에 앞서 자료와 학습 목표를 정해 모델의 매개변수를 학습하는 과정이다. **사전학습 모델(pretrained model)**에는 이렇게 학습한 가중치가 저장되어 있다. 여기서 ‘사전’은 시간적 순서를 뜻한다. 사전학습을 마쳤다는 사실만으로 조경의 모든 대상을 인식할 수 있는 것은 아니다.
**기반모델(foundation model)**은 폭넓은 자료에서 학습하여 여러 후속 과제의 기반으로 활용할 수 있는 모델을 가리킨다. 시각 기반모델은 이미지·영상의 표현이나 인식 능력을 재사용한다. 범용적인 표현을 다른 문제에 적용할 수 있다는 점이 중요하며, 큰 모델이나 사전학습 모델을 모두 기반모델이라고 부르지는 않는다. 이 용어는 특정한 하나의 신경망 구조를 뜻하지도 않는다. Stanford CRFM의 기반모델 정의
앞 절의 CNN·ViT는 주로 계산 구조를 설명하는 이름이었다. 기반모델은 그 구조를 어떤 자료와 목적으로 학습하여 여러 과제에 쓰는지에 초점을 둔다. 따라서 ‘CNN 대신 기반모델을 쓴다’는 표현은 서로 다른 구분을 섞는다. CNN이나 ViT를 활용한 모델도 사전학습된 표현을 제공할 수 있다.
학습에는 여러 방식이 있다. 사람이 정한 범주와 영상을 짝지어 배우는 지도학습 외에, **자기지도학습(self-supervised learning)**은 자료 자체에서 학습 신호를 구성한다. 예를 들어 같은 영상에서 다르게 잘라내거나 변형한 입력 사이의 표현이 대응하도록 배울 수 있다. 이미지마다 수종 이름을 사람이 붙이지 않아도 표현을 학습할 수 있다는 뜻이지, 자료 선정과 학습 목적에서 사람의 판단이 사라진다는 뜻은 아니다.
DINOv3는 이러한 시각 표현 재사용의 한 예다. 개발진은 같은 이미지에서 만든 서로 다른 변형의 특징을 대응시키며 표현을 학습하고, 후속 과제에 맞는 가벼운 모듈을 학습하는 활용 방식을 설명한다. 여기서 모델이 제공하는 특징 벡터가 곧바로 ‘느티나무’라는 이름이나 수고가 되는 것은 아니다. 필요한 출력으로 바꾸는 과정이 이어져야 한다. DINOv3 공식 연구 소개 — 학습과 과제 적응
전이학습: 이미 배운 것을 새 과제에 연결하기
**전이학습(transfer learning)**은 다른 자료나 과제에서 학습한 표현·매개변수 등을 현재 문제에 활용하는 접근이다. 시각 모델에서 입력을 특징으로 바꾸는 부분을 인코더(encoder), 그 특징을 범주나 마스크 같은 과제별 출력으로 바꾸는 부분을 **헤드(head)**라고 부른다. 여러 작업의 바탕이 되는 특징 추출부를 **백본(backbone)**이라고도 한다. 실제 모델의 구성은 다르지만, 이 구별은 재사용 범위를 이해하는 데 유용하다.
기존 시각 인코더의 가중치를 **동결(freeze)**하고 새 분류 헤드만 학습할 수 있다. 동결은 정해 둔 매개변수를 학습 중 갱신하지 않는 것이다. 반면 **미세조정(fine-tuning)**에서는 사전학습한 가중치를 출발점으로 삼아 일부 또는 전체를 현재 과제에 맞게 추가 학습한다. PyTorch의 전이학습 안내도 고정된 특징 추출부를 쓰는 경우와 기존 모델을 추가 학습하는 경우를 구별한다. PyTorch 전이학습 안내
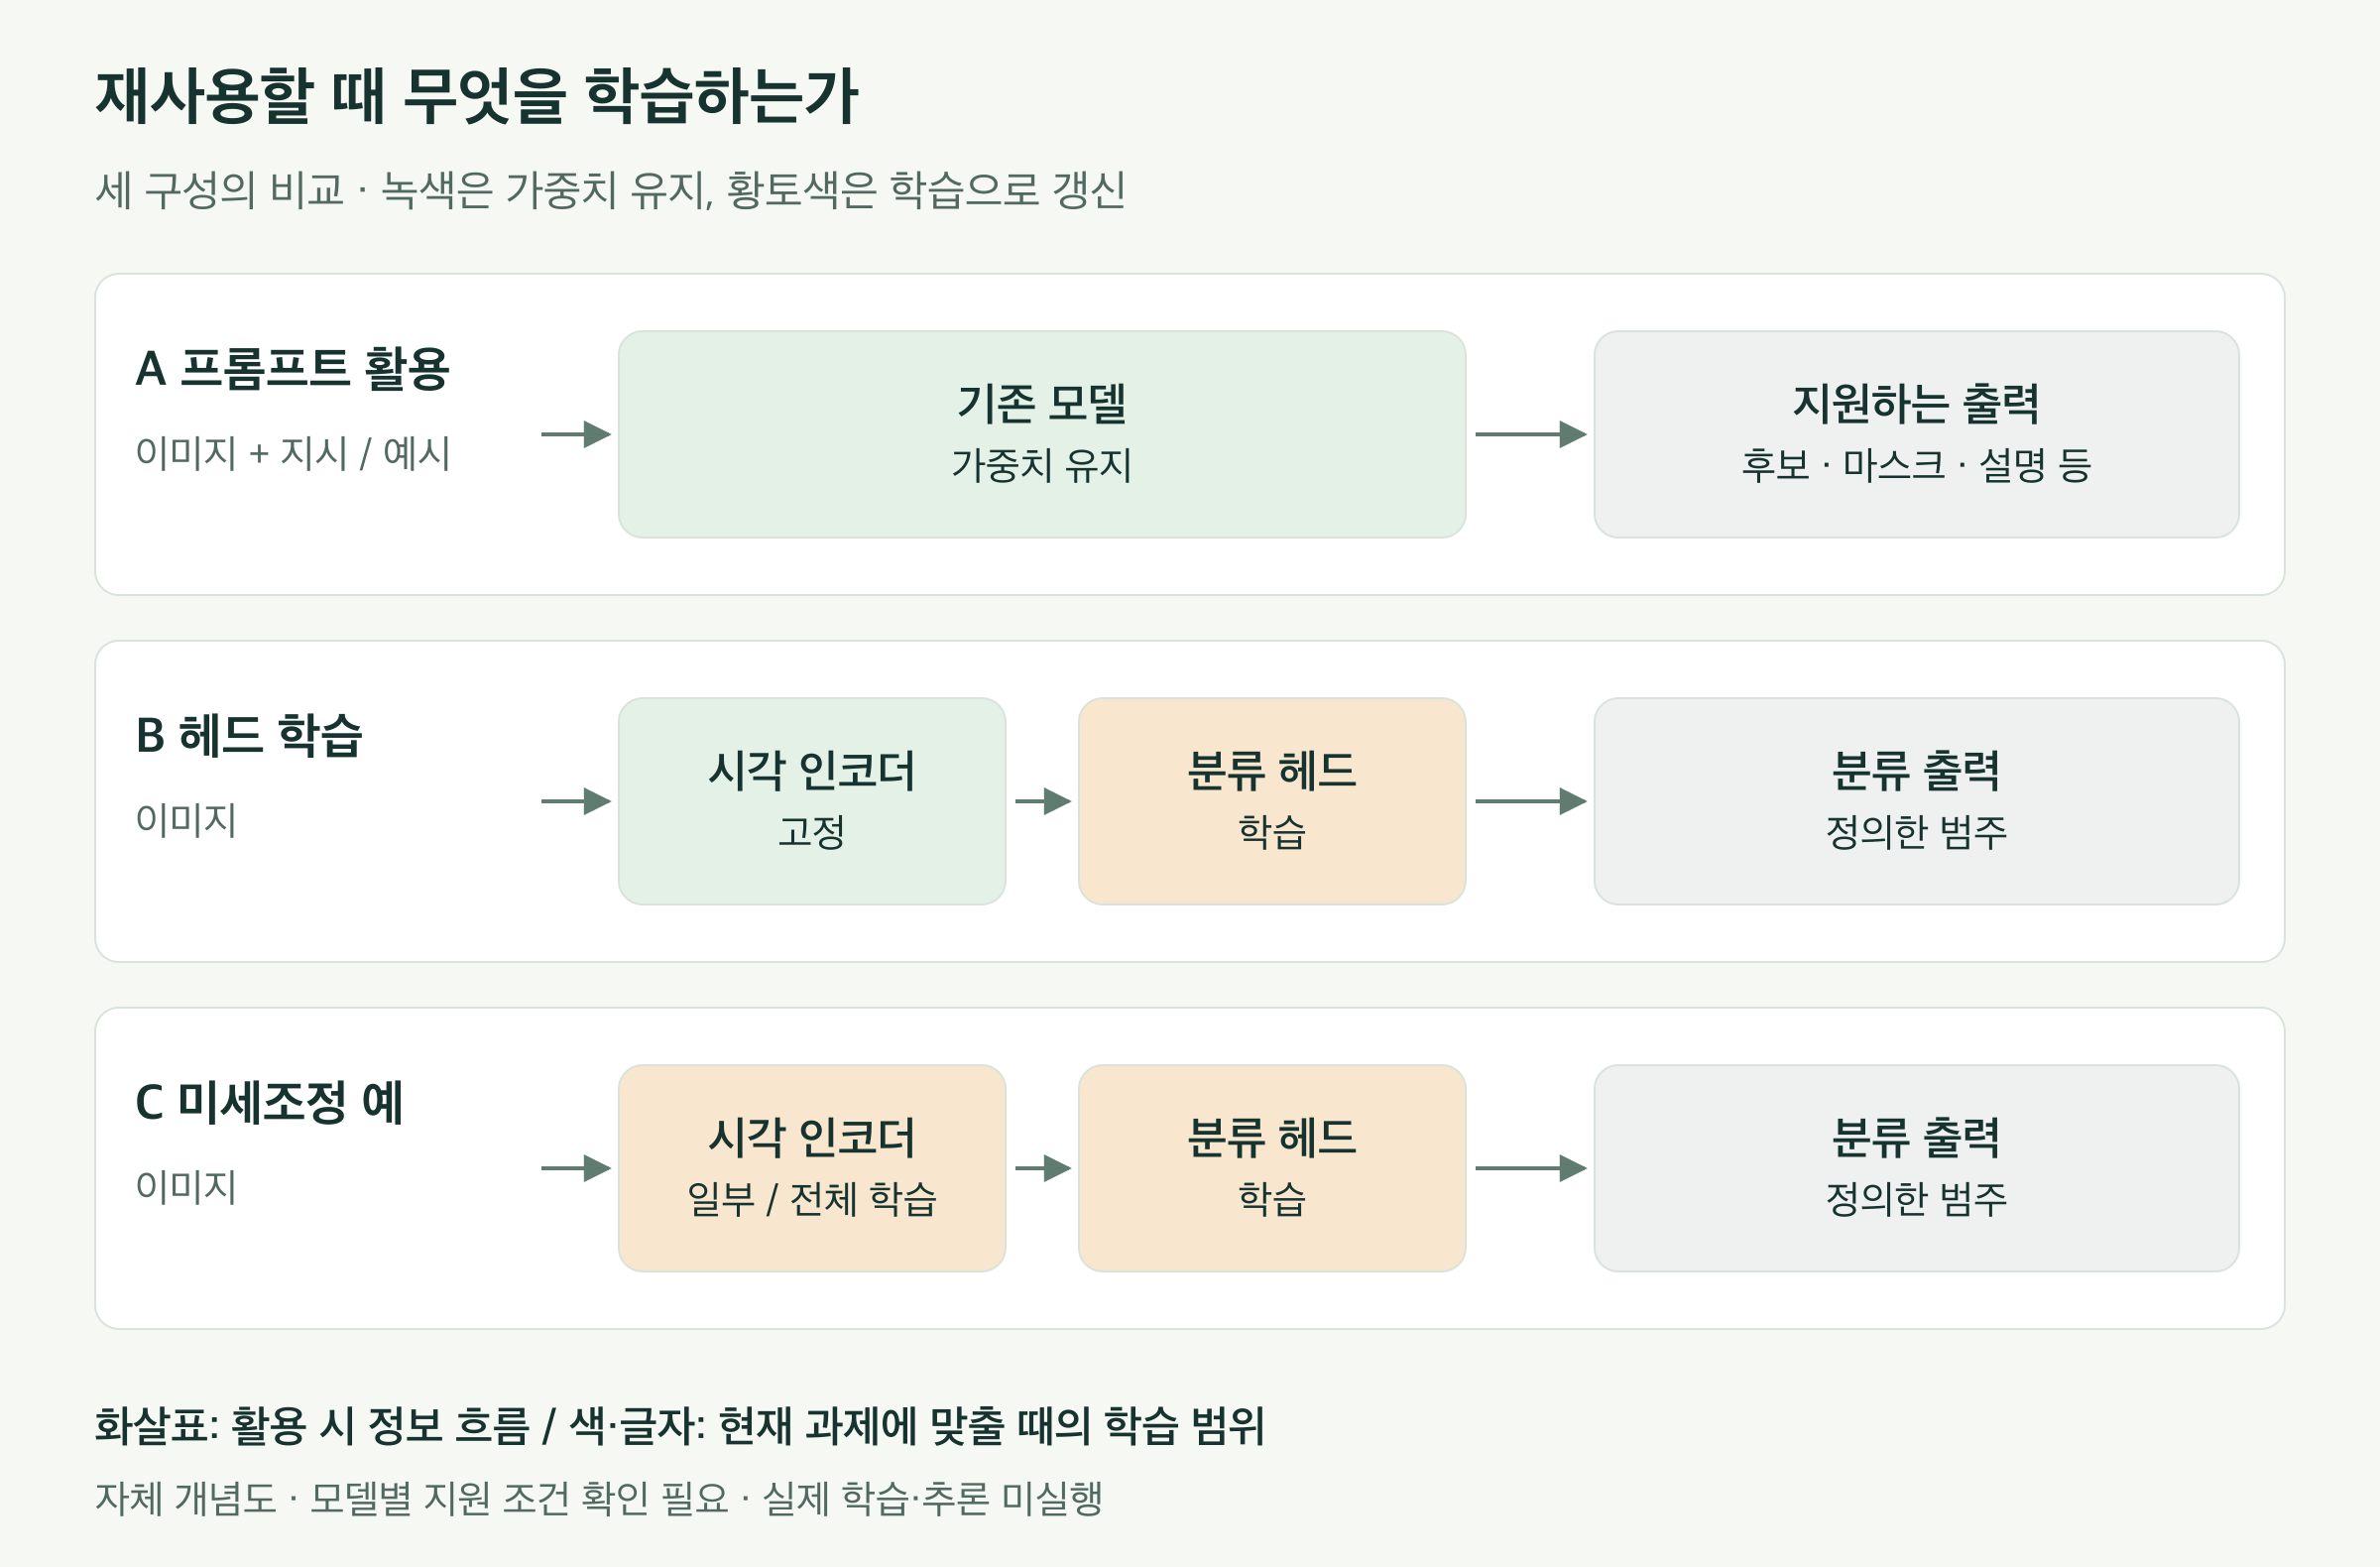
세 가지 활용 구성을 비교한다. 프롬프트 활용에서는 기존 모델의 가중치를 유지한다. 분류 헤드 학습에서는 시각 인코더를 고정하고 분류 헤드만 학습한다. 미세조정 예에서는 시각 인코더의 일부 또는 전체와 분류 헤드를 학습한다.
그림. 이미 학습한 모델을 활용할 때 무엇을 바꾸는가. 자체 개념도이며 색과 글자는 현재 과제에 맞추는 단계의 가중치 갱신 여부를 나타낸다. 화살표는 입력에서 출력으로 이어지는 구성이며 학습 순서나 성능 순위가 아니다. 실제 학습은 수행하지 않았다.
가상 공원에서 ‘판석포장·잔디·초본 식재지’를 구별한다고 하자. 인코더를 고정하고 분류 헤드를 학습한다면, 이미 만들어진 특징에서 세 범주를 구별하는 방법을 배운다. 미세조정한다면 특징을 만드는 부분도 바꿀 수 있다. 후자는 적응의 범위가 넓지만, 적은 자료의 우연한 배경이나 촬영 조건까지 따라 배울 수 있다. 바꾸는 매개변수가 많다는 이유만으로 실제 현장에서 더 잘 구별한다고 결론 내릴 수는 없다.
매개변수 중 작은 일부만 학습하는 **매개변수 효율적 미세조정(PEFT)**도 있다. 대표적인 LoRA는 기존 가중치를 고정한 채, 작은 두 행렬의 곱으로 표현하는 가중치 변화분을 학습하는 방법을 제시했다. 이는 프롬프트를 입력하는 것과 달리 학습되는 매개변수가 있는 방식이다. 이 절에서는 원리만 소개하며 특정 시각 모델에서의 지원 여부나 메모리 절감량은 가정하지 않는다. LoRA 원 논문 초록
Zero-shot과 few-shot: 예시는 어디에 쓰이는가
**프롬프트(prompt)**는 수행할 일이나 찾을 대상을 지정하는 입력이다. 문장뿐 아니라 점, 상자, 예시 영상 등이 될 수 있으며 받아들이는 형식은 모델마다 다르다. ‘이 위치의 수관을 나누어라’는 점 입력과 ‘판석포장을 찾아라’는 문장 입력은 서로 다른 정보를 제공한다.
Zero-shot은 해당 평가 과제의 정답 예시를 추가로 사용하지 않고 이미 학습한 능력과 범주 설명 등으로 수행하는 설정을 말한다. 예를 들어 이미지·언어의 대응을 학습한 모델에 ‘잔디’, ‘판석포장’, ‘초본 식재지’라는 설명을 주고 이미지와 비교할 수 있다. 이는 모델이 아무 자료도 배우지 않았다는 뜻이 아니며, 사전학습에서 유사 대상을 접하지 않았다는 보장도 아니다. 무엇에 대해 zero-shot인지 범위를 밝혀야 한다. CLIP의 zero-shot 적용 방법
Few-shot은 새 과제에 소수의 예시를 활용하는 설정을 가리키지만, 예시를 쓰는 방법은 하나가 아니다. 적은 라벨 자료로 분류기를 학습할 수도 있고, 추론할 때 예시와 답을 입력에 함께 넣을 수도 있다. 후자를 **문맥 내 학습(in-context learning)**이라고 부른다. 이 방식에서는 현재 입력의 예시를 참고하며, 그 요청만으로 모델 가중치가 갱신되지는 않는다. Brown 등의 연구는 추론 시 예시를 제공하면서 가중치를 갱신하지 않는 설정을 명시했다. 이 구별을 영상·언어 모델에 적용할 때에도 예시 이미지와 답을 함께 처리할 수 있는 모델인지 확인해야 한다. Few-shot과 문맥 내 학습의 구별 — 원 논문 §2
| 활용 설정 | 조경 자료나 예시를 쓰는 위치 | 이번 활용에서 가중치 갱신 | 밝혀야 할 조건 |
|---|---|---|---|
| Zero-shot 적용 | 과제 설명·범주 이름 등을 입력 | 하지 않음 | 정답 예시를 추가하지 않은 범위와 후보 범주 |
| 문맥 내 few-shot | 새 입력 앞에 예시 이미지·답을 함께 제공 | 하지 않음 | 예시의 수·선정·입력 형식 |
| 소수 자료로 헤드 학습 | 라벨 자료로 분류부 등을 학습 | 헤드 갱신 | 범주별 자료 수와 평가 자료 분리 |
| 미세조정 | 라벨 자료나 과제별 학습 신호로 추가 학습 | 선택한 매개변수 갱신 | 갱신한 부분과 학습·평가 조건 |
표의 설정들은 성능이 낮은 것부터 높은 것으로 나열한 단계가 아니다. 또한 few-shot은 모든 분야에서 ‘다섯 장’처럼 정해진 수를 뜻하지 않는다. 세 범주에 두 장씩을 사용한다면 ‘범주별 두 장, 총 여섯 장’이라고 기록하고, 그 여섯 장을 입력 예시로 썼는지 학습자료로 썼는지를 구별한다. 이 숫자는 설명용 구성이지 조경 영상 분석에 충분한 자료량을 뜻하지 않는다.
점이나 상자를 넣어 분할 결과를 고치는 상호작용도 자동으로 미세조정이 되지는 않는다. 수정 입력을 이용해 이번 출력만 다시 계산하는 것과, 검토한 자료를 모아 모델의 가중치를 갱신하는 것은 다른 절차다. 이 차이를 알면 도구에서 ‘AI에게 알려 주었다’는 표현이 실제로 무엇을 뜻하는지 판단할 수 있다.
범용적인 표현과 필요한 출력 사이
SAM 3는 짧은 명사구나 예시 이미지 등으로 대상을 지정하고, 그에 맞는 객체의 탐지·분할·추적을 수행하는 방법을 제시했다. ‘무엇을 찾을지’를 고정된 범주 번호 외의 입력으로 전달하는 사례다. 그러나 어떤 말을 입력해도 조경 전문 범주를 정확히 구별한다는 뜻은 아니다. 예를 들어 ‘초본 식재지’라는 설계 분류와 ‘작은 식물이 모여 보이는 영역’은 일치하지 않을 수 있다. SAM 3 원 논문 초록
기반모델을 선택할 때에는 필요한 출력을 먼저 확인한다. 특징 벡터를 제공하는 모델에는 분류나 분할을 위한 구성이 더 필요할 수 있다. 마스크를 만드는 모델이 수종 이름까지 출력하는 것도 아니며, 범주를 맞히는 모델이 위치를 알려 주는 것도 아니다. 조경에서의 활용 가능성은 모델의 입력·출력과 업무의 질문이 맞는지에서 출발한다.
2026년 9월에 확인한 DINOv3와 SAM 3는 이러한 방법의 최근 예다. 모델 이름은 원리를 이해하는 연결점으로 사용하며 최신 성능 순위로 제시하지 않는다. 설치 실습을 진행할 때에는 사용할 가중치·코드 버전과 입력 형식, 이용조건을 별도로 확인한다. 이 단위에서는 가중치를 내려받거나 모델을 실행하지 않았다.
4.7 영상·언어 모델: 보이는 것과 말의 연결
서로 다른 자료를 연결한다는 의미
**영상·언어 모델(Vision-Language Model, VLM)**은 영상과 언어를 함께 다루어 두 자료의 대응을 학습하는 모델이다. 여기서 **모달리티(modality)**는 이미지·텍스트처럼 정보가 표현되는 자료의 종류를 뜻한다. VLM에는 영상과 문장의 유사도를 계산하는 방식도 있고, 영상을 조건으로 문장을 생성하는 방식도 있다. 대화가 가능한 모델만을 가리키는 용어는 아니다.
가상 공원의 사진 모음에서 ‘판석 길 옆의 초본 식재지’를 찾는 일과, 특정 사진을 보고 보이는 요소를 문장으로 정리하는 일은 서로 다른 출력이 필요하다. 전자는 사진과 문장의 대응을 이용한 검색이고, 후자는 영상에 근거한 문장 생성이다. 두 방식을 구별하면 검색 점수를 설명문으로 오해하거나, 설명문을 위치가 검증된 객체 목록으로 받아들이는 일을 줄일 수 있다.
CLIP형 모델: 이미지와 문장의 대응을 비교하기
CLIP은 이미지 인코더와 텍스트 인코더를 함께 학습하여 두 자료를 비교 가능한 임베딩으로 바꾸는 방법을 제시했다. 실제로 짝지어진 이미지·문장의 대응을 다른 조합과 구별하도록 학습하는 **대조학습(contrastive learning)**을 사용한다. 기본 CLIP은 새 문장을 작성하는 모델이 아니라 이미지와 주어진 문장의 대응 점수를 계산하는 모델이다. CLIP 원 논문 §2.3
공원 사진 한 장과 ‘판석포장’, ‘잔디’, ‘초본 식재지’라는 후보 설명이 있다고 하자. 각각을 임베딩으로 바꾼 뒤 이미지 표현과 어느 문장 표현이 가까운지 비교한다. 반대로 한 문장과 여러 사진을 비교하면 문장에 가까운 사진 후보를 정렬할 수 있다. 이 절에서는 임베딩의 방향을 비교한다는 직관까지만 사용하며 실제 점수는 만들지 않는다.
후보 중 첫 번째라는 사실은 정답이라는 뜻과 다르다. 모든 후보가 사진과 맞지 않아도 그중 하나는 가장 높은 점수를 받을 수 있다. 후보의 표현을 바꾸거나 범주를 추가하면 결과도 달라질 수 있다. ‘수목’이라는 넓은 설명을 찾는 것과 잎이 잘 보이지 않는 장면에서 세부 수종을 고르는 것은 요구하는 시각 정보가 다르다.
생성형 VLM: 영상 정보를 조건으로 문장 만들기
생성형 VLM은 영상에서 얻은 표현과 사용자의 문장 등을 연결하여 답변을 생성한다. 대표적인 구성에서는 시각 인코더가 이미지의 특징을 만들고, 연결부가 이 특징을 언어모델이 처리할 수 있는 표현으로 바꾸며, 언어모델이 입력을 조건으로 다음 토큰을 생성한다. 모든 모델이 같은 구조를 쓰지는 않는다.
Qwen3-VL 기술 보고서는 시각 인코더·영상과 언어를 연결하는 모듈·언어모델의 구성을 설명하며 이미지·여러 이미지·영상 입력을 다룬다. 이는 영상의 표현을 언어 처리와 연결한 최근 방법 사례다. 이 책에서는 세부 규모나 성능표를 옮기기보다, 영상 정보가 어떤 경로로 답변에 사용되는지를 이해하는 데 활용한다. Qwen3-VL 원 논문 — Model Architecture
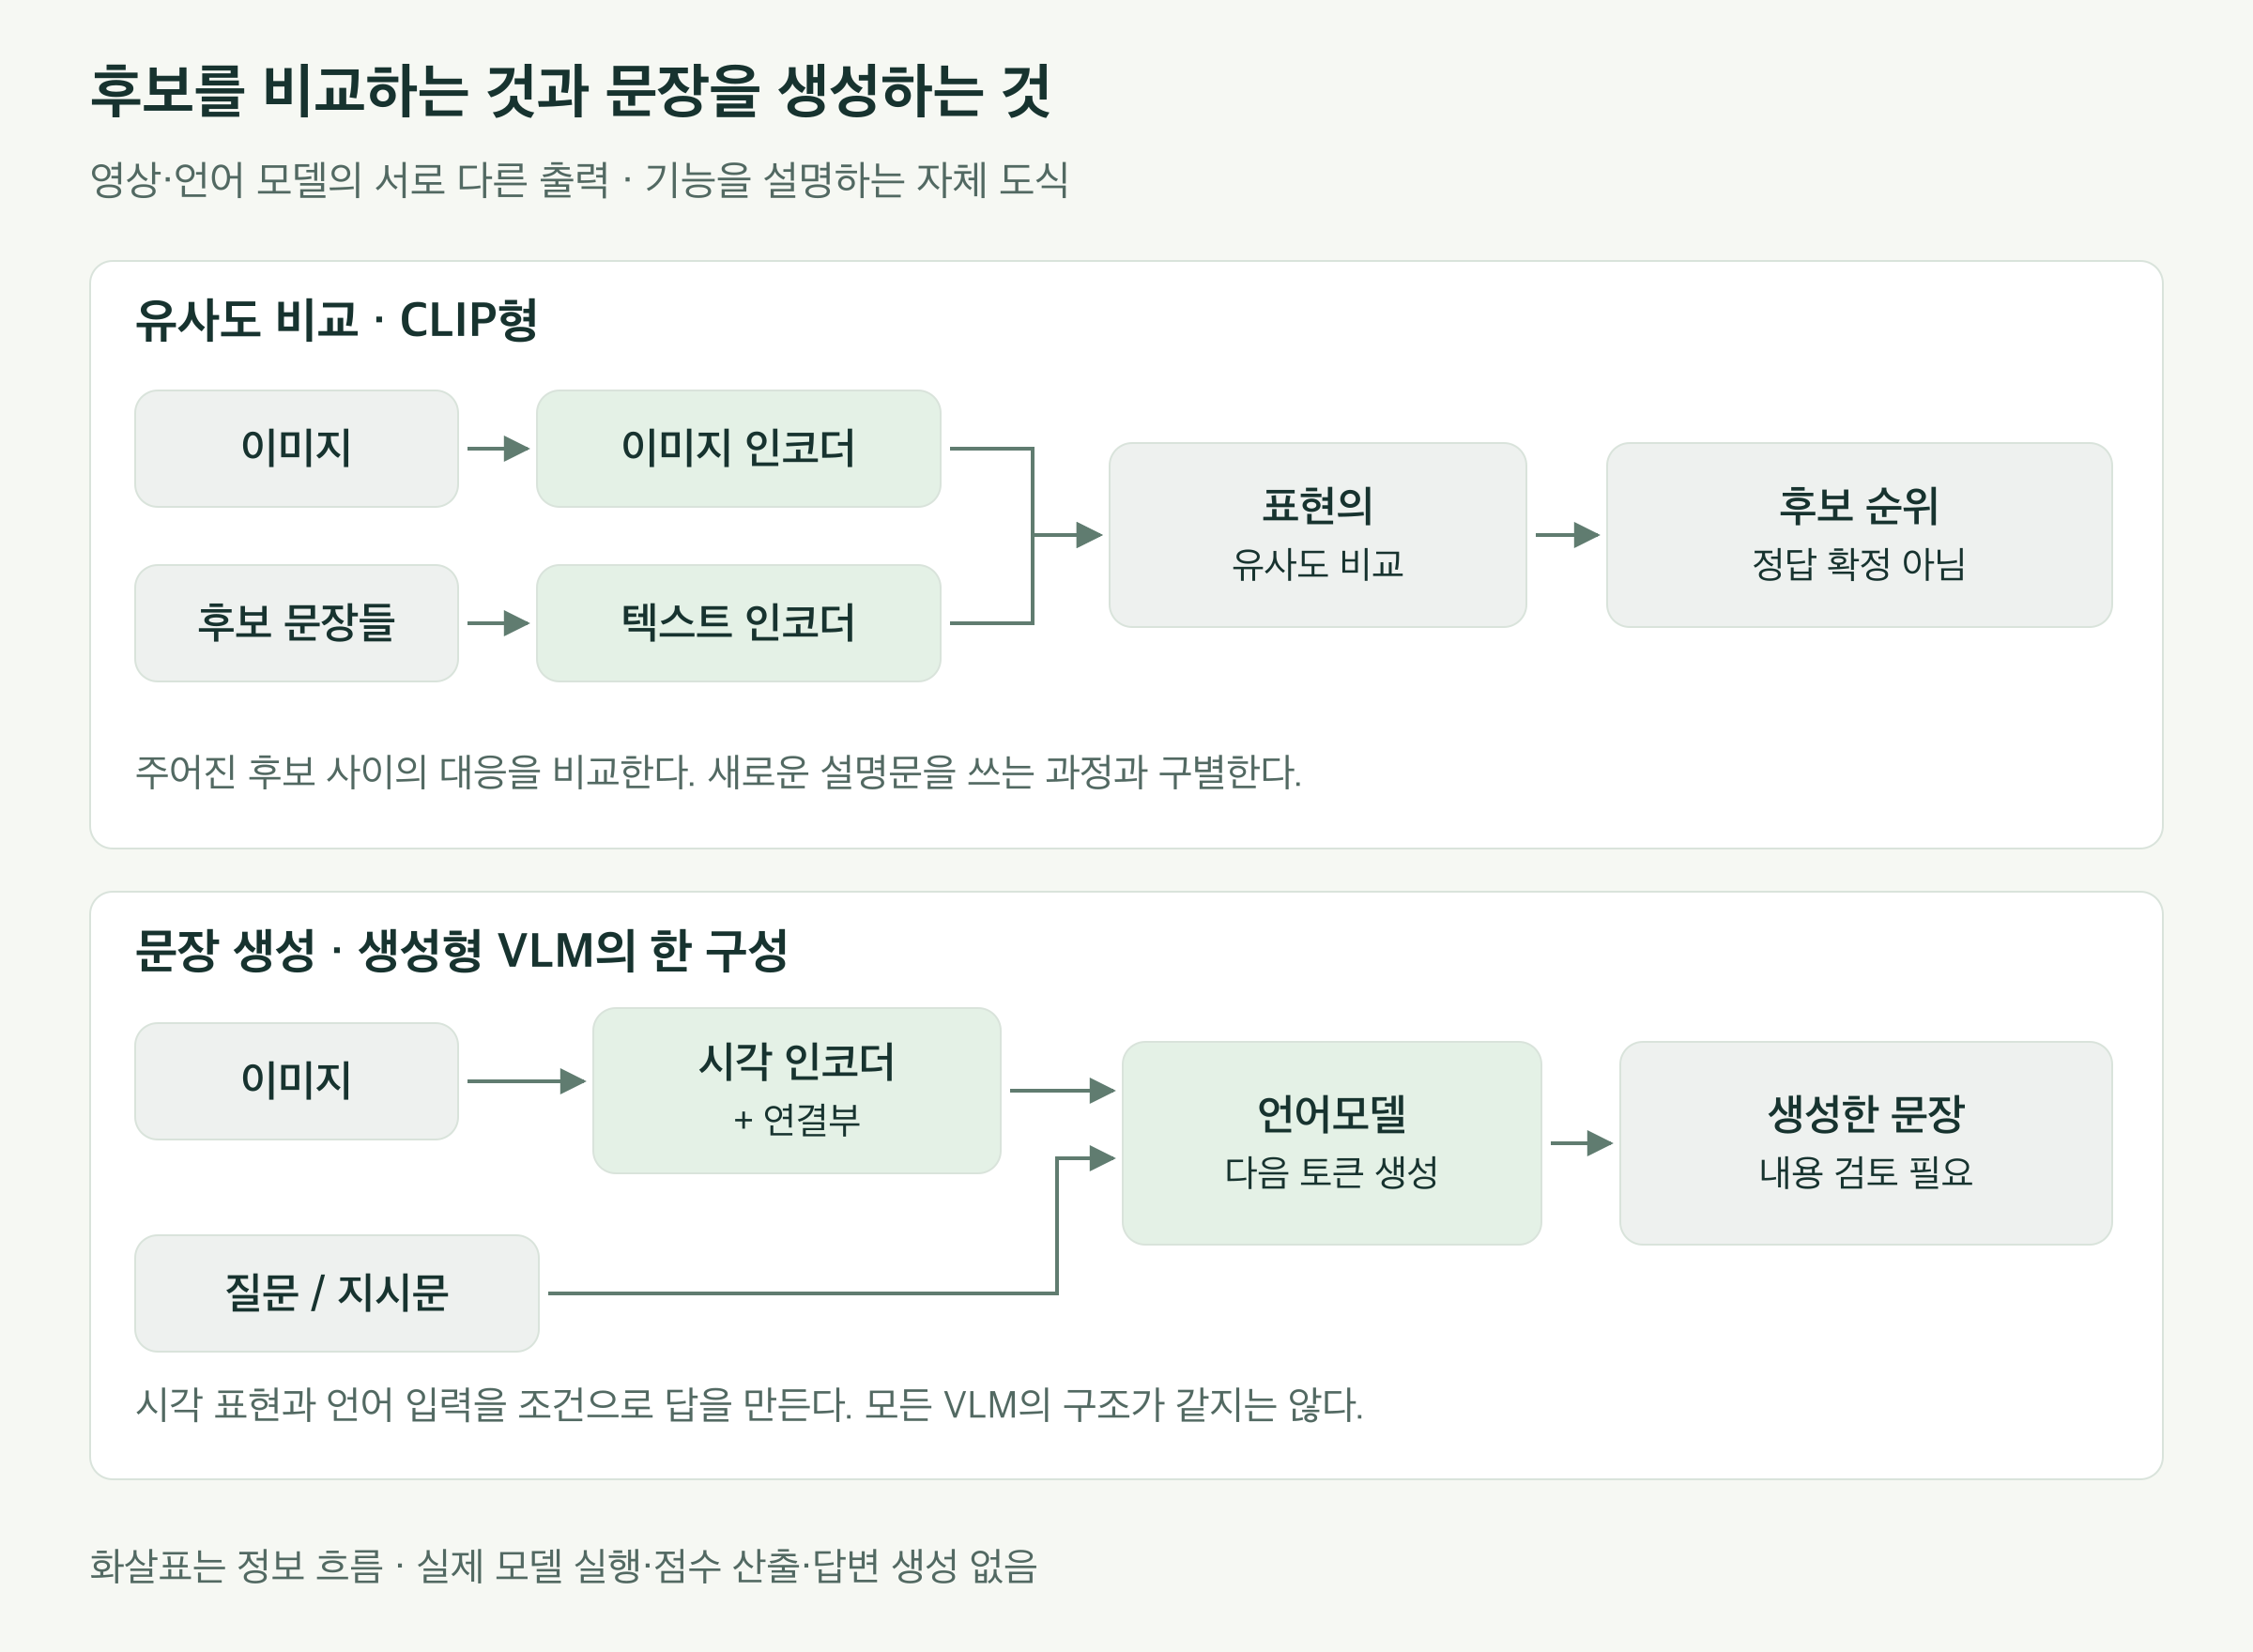
위쪽은 이미지와 후보 문장을 각각 표현으로 바꾸어 유사도를 비교하고 후보 순위를 얻는 CLIP형 방식이다. 아래쪽은 영상 표현과 질문을 언어모델에 연결하여 새로운 문장을 생성하는 방식이다. 두 출력은 검토 전 후보이며 실제 모델 실행 결과가 아니다.
그림. 후보의 대응을 비교하는 것과 답변을 생성하는 것. 기능의 차이를 설명하는 자체 도식으로 특정 논문의 구조도를 재현한 것이 아니다. 화살표는 정보 흐름이다. 분할·탐지 등의 출력은 모델의 지원 기능이나 별도 도구에 따라 추가될 수 있다.
생성형 모델은 ‘보행로 주변의 요소를 설명해 달라’, ‘두 사진에서 달라 보이는 부분을 정리해 달라’처럼 작업을 언어로 지정할 수 있다. 하지만 말로 물을 수 있는 범위와 영상에서 확인할 수 있는 범위는 같지 않다. 일부 모델이 좌표나 상자를 출력하도록 학습되어 있어도, 그 값이 현장 좌표나 검측 결과로 바로 확정되지는 않는다.
가상 공원의 기록을 준비하는 작은 예
판석 길과 초본 식재지, 집수정이 있는 가상 공원에서 촬영 자료를 정리하는 상황을 생각해 보자. 다음은 해당 모델이 지원하는 이미지 입력에 붙일 수 있는 자체 요청문 예다. 실제 사진을 넣어 실행한 기록은 아니다.
영상에서 보이는 포장·식재·배수시설 후보를 구분해 적어라. 각 항목에 영상 안의 위치와 눈에 보이는 근거를 함께 적어라. 가려지거나 해상도가 부족한 부분은 확인 불가로 남겨라. 영상에 없는 치수나 지하 구조는 추정하여 채우지 마라.
여기서 유용한 변화는 사진을 보며 작성하던 첫 목록을 디지털 기록의 후보로 만들 수 있다는 점이다. 후보를 검색하거나 검토 담당자에게 전달하려면 문장 전체만 저장하기보다 항목별로 나누어 둘 수 있다. 아래는 이 책에서 제안하는 기록 구조이며 VLM이 자동으로 정확히 채운 결과가 아니다.
| 기록 항목 | 남기는 목적 | 사람의 검토에서 확인할 점 |
|---|---|---|
| 원 영상 ID와 촬영 시각 | 판단의 출처를 찾기 | 파일과 시각이 실제 자료에 대응하는가 |
| 영상 안의 위치·영역 | 어느 부분의 설명인지 찾기 | 문장과 표시 영역이 같은 대상을 가리키는가 |
| 모델이 제안한 범주와 근거 | 인식 후보를 검토하기 | 범주 정의와 보이는 특징이 맞는가 |
| 확인 불가 항목 | 관측되지 않은 정보를 남기기 | 가림·해상도 부족을 확정값으로 바꾸지 않았는가 |
| 검토 결과·수정 내용 | 후보와 확인한 기록을 구별하기 | 수정한 사람과 대상·시점이 남는가 |
예를 들어 격자 모양 뚜껑이 보인다는 설명은 배수시설 후보를 찾는 단서가 될 수 있다. 그 설명만으로 아래 관로의 직경, 연결 상태, 통수 능력을 알 수는 없다. 잎이 갈색으로 보인다는 진술도 색의 관측과 원인 판단을 나누어야 한다. 계절·조명·생리적 상태 등 가능한 원인을 확인하는 일은 별도의 자료와 검토가 필요하다.
이처럼 영상에 근거한 기술, 대상의 해석, 현장 판단을 구별해 기록하면 자동화할 부분이 분명해진다. 사진 후보를 검색하고 첫 목록을 만드는 일에는 표현 재사용과 VLM을 검토할 수 있다. 치수·배수 기능·수목 상태의 확정은 그에 맞는 관측과 분석을 연결해야 한다. 요청문에 ‘추정하지 말라’고 쓰는 것만으로 오류가 사라지지는 않으므로, 검토되지 않은 출력에는 후보 상태를 유지한다.
다음 단위에서는 이런 모델이 같은 공원에서도 계절·빛·가림에 따라 다른 결과를 내는 이유를 살펴본다. 이어 어떤 자료와 지표로 인식 성능을 평가해야 하는지 설명한다.
이 단위의 공원 상황·범주별 예시 수·요청문·기록 구조는 자체 설명용이다. 모델 학습·추론·이미지 검색·프롬프트 성능 비교를 실행한 결과가 아니다. 출처와 실제 열람 범위를 별도로 기록했다.
5단위. 조경의 관측 변화와 성능평가
4장 5단위 · 4.8–4.9 · v0.1 검토용 초고
여름에 공원 수관을 잘 구분한 모델을 겨울에도 그대로 사용할 수 있을까? 잎이 줄어 수관의 모습이 달라졌을 수도 있고, 촬영 위치가 바뀌어 줄기가 가려졌을 수도 있다. 모델이 다른 결과를 냈다는 사실만으로 현장이 변했다고 판단할 수는 없다. 반대로 실제로 전정하거나 수목을 옮겼는데도 이전 결과와 같아야 한다고 요구해서도 안 된다. 시각 AI를 활용하려면 무엇이 달라졌는지 살피는 일과, 결과를 어떤 기준으로 평가할지 정하는 일이 함께 필요하다.
4.8 조경공간이 시각 AI에게 어려운 이유
같은 대상도 여러 모습으로 관측된다
조경공간에는 일정한 외형을 유지하지 않는 대상이 많다. 같은 수종 안에서도 개체의 크기와 가지 형태가 다르고, 서로 다른 초본류가 비슷한 질감으로 보이기도 한다. 수목의 가지와 잎은 바람에 움직이고, 여러 수관이 겹치면 영상에서 개별 경계를 찾기 어렵다. 시설물과 포장도 그림자·젖음·오염·시점에 따라 다르게 보인다.
**가림(occlusion)**은 다른 대상 때문에 관측하려는 부분이 보이지 않는 상태다. 초본류가 집수정 뚜껑을 덮었다면 뚜껑의 일부는 영상에 들어오지 않는다. 모델을 개선하는 일과 함께, 현재 입력에 판단에 필요한 정보가 있는지도 확인해야 한다. 흐려진 작은 잎을 확대해 보이는 픽셀 수를 늘려도 원래 촬영되지 않은 세부 정보가 자동으로 복구되는 것은 아니다.
여기서는 영상의 차이를 세 관점으로 나누어 읽는다. 실제 현장에서는 이들이 동시에 나타날 수 있다.
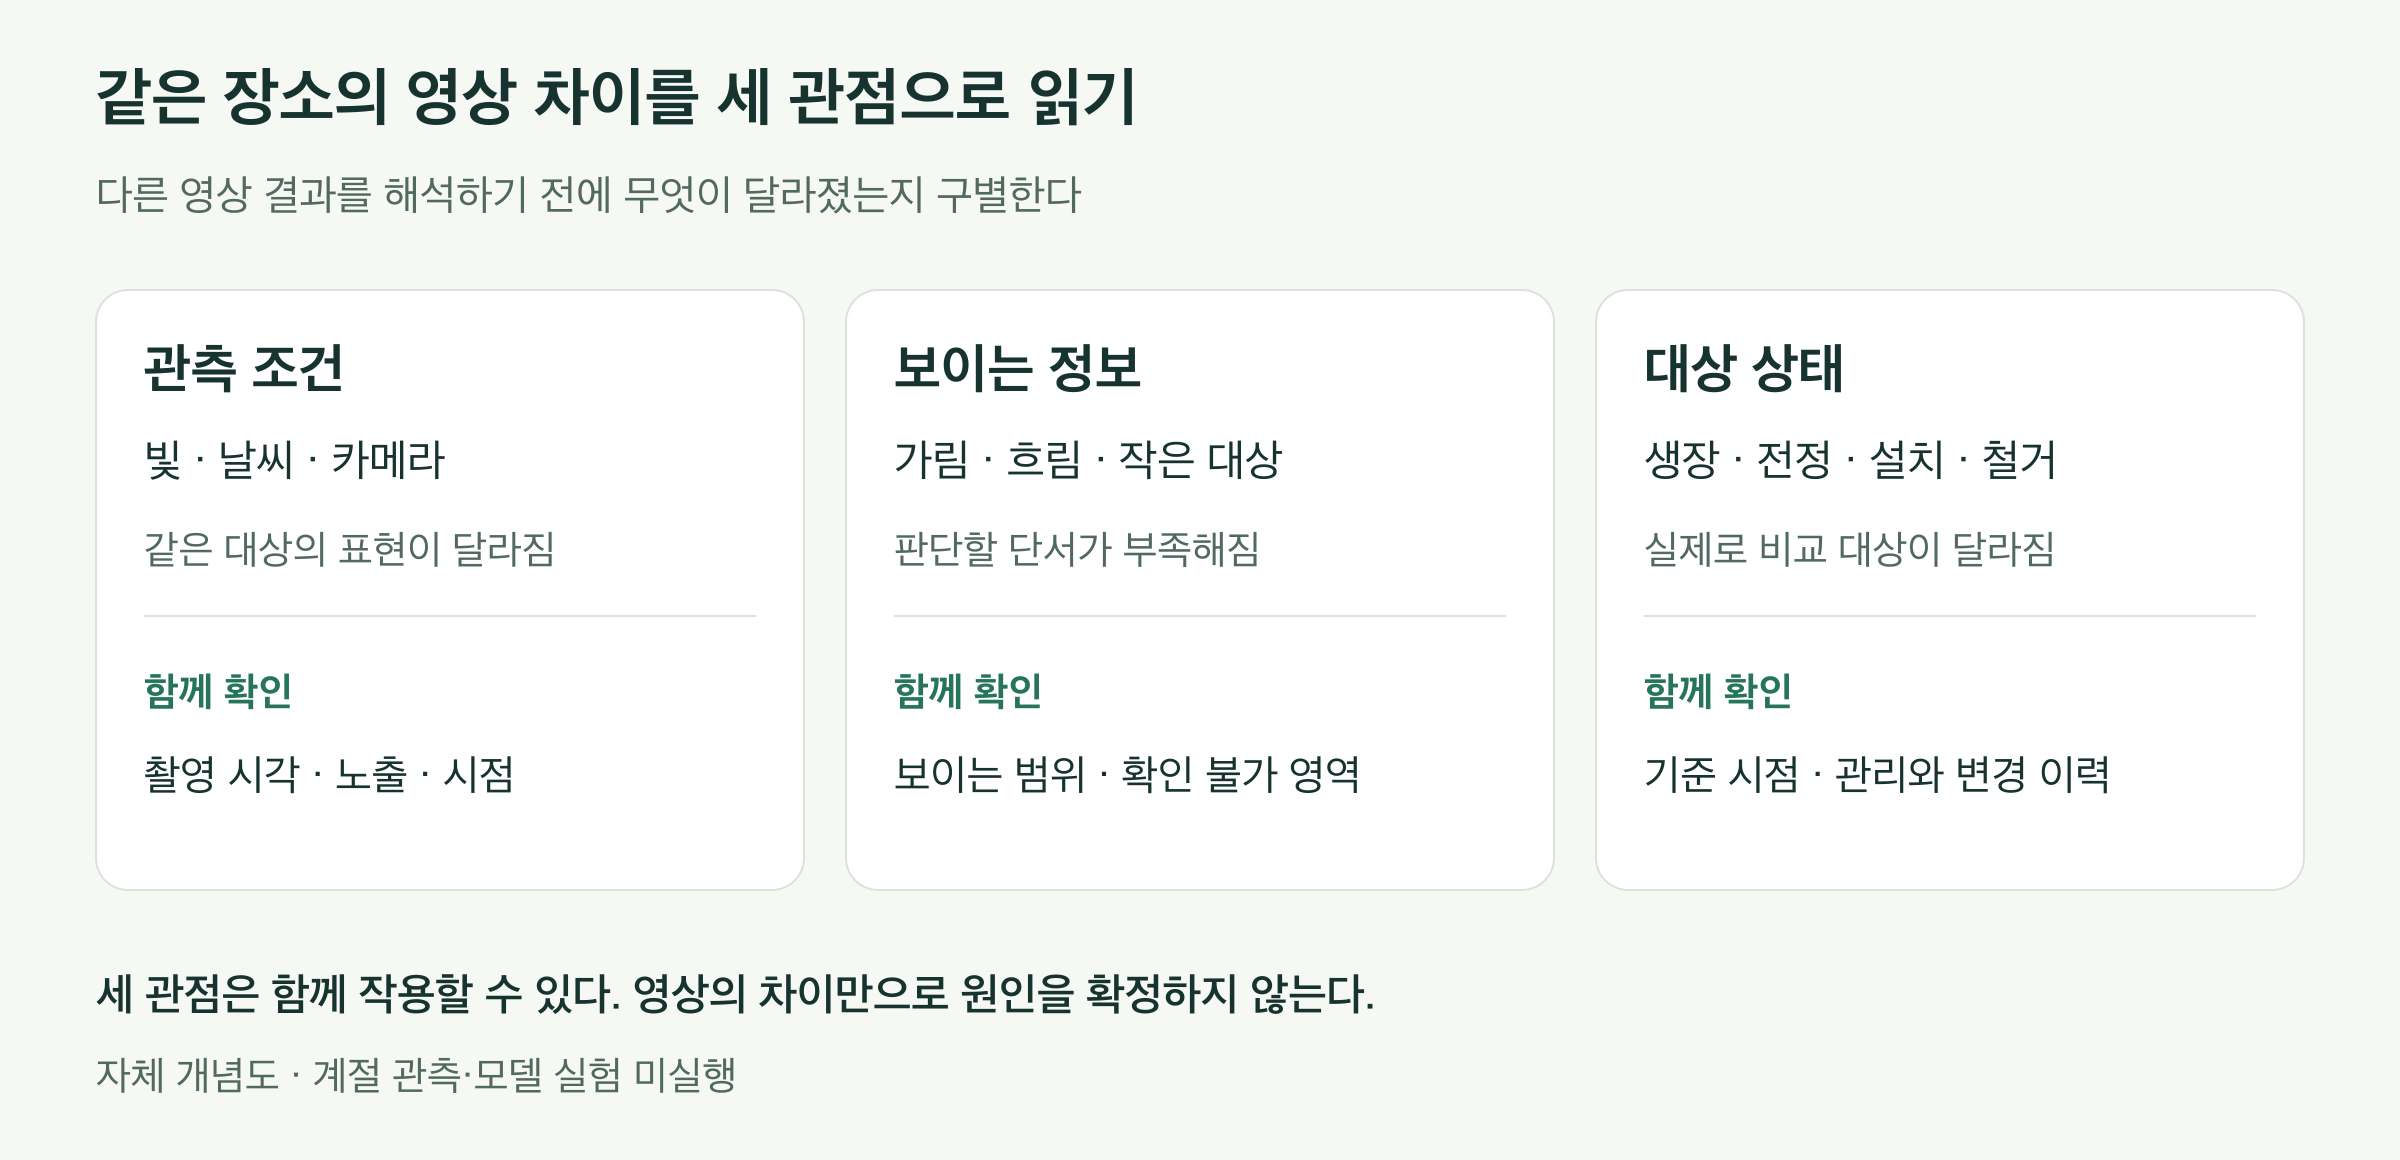
같은 장소의 영상 차이를 관측 조건, 보이는 정보, 대상 상태의 세 관점으로 구분한다. 빛과 카메라는 표현 조건, 가림과 해상도는 확인 가능한 정보, 생장과 전정은 실제 대상 상태를 바꿀 수 있다. 각각 촬영 조건, 확인 불가 영역, 기준 시점과 변경 이력을 함께 살핀다.
그림. 같은 장소의 영상 차이를 읽는 세 관점. 자체 개념도다. 세 항목은 서로 배타적인 원인 분류가 아니며, 같은 장면에서 함께 작용할 수 있다. 실제 계절 관측을 수행한 결과는 아니다.
관측 조건이 달라진 경우에는 같은 포장이 역광이나 젖음 때문에 다르게 보일 수 있다. 보이는 정보가 달라진 경우에는 수목 뒤의 벤치가 가려져 인식할 근거가 줄어든다. 실제 상태가 달라진 경우에는 전정 후 수관 범위나 새로 설치한 시설물처럼 정답으로 삼을 기록도 달라질 수 있다. 이러한 차이를 모두 ‘모델 오류’나 ‘현장 변화’ 하나로 묶으면 원인을 잘못 해석하기 쉽다.
도메인과 분포 변화
**도메인(domain)**은 자료가 공통으로 가진 생성 환경이나 조건을 묶어 부르는 말이다. 조경 영상에서는 촬영 장소·카메라·계절 등을 기준으로 도메인을 정할 수 있다. **분포 변화(distribution shift)**는 학습할 때와 평가·활용할 때 자료의 통계적 특성이 달라지는 상황이다. 서로 다른 장소나 관측 환경 사이에서 일어나는 변화를 도메인 시프트(domain shift)라고 부르기도 한다.
한 장의 사진이 다르게 보인다는 사실만으로 자료 전체의 분포 변화를 입증한 것은 아니다. 학습자료가 맑은 날의 근접 사진에 치우쳐 있는데 활용자료는 흐린 날의 높은 시점 영상으로 구성된다면, 어떤 조건과 대상이 얼마나 포함되어 있는지 비교해야 한다. WILDS 연구는 카메라 위치나 지역 등이 달라지는 조건을 분리하여 평가하는 방법을 제시한다. 조경에서도 적용하려는 조건을 평가 자료에 반영한다는 관점으로 참고할 수 있다. WILDS의 도메인 정의와 관측 환경 변화
| 조경 영상의 변화 | 인식에서 확인할 문제 | 비교에 남길 조건 |
|---|---|---|
| 계절·생장·전정 | 같은 개체의 외형 변화인가, 실제 관리 상태의 변화인가 | 촬영일, 수종·개체, 관리 이력 |
| 빛·날씨·그림자·젖음 | 재료나 상태를 조명 효과와 혼동하는가 | 날씨·시간대, 노출 조건 |
| 수관 중첩·시설물 가림 | 보이는 부분만으로 개체를 구별할 수 있는가 | 가림 여부, 판정 가능한 범위 |
| 작은 대상·흐림·카메라 변경 | 필요한 특징이 입력에 남아 있는가 | 영상 크기, 대상의 픽셀 크기, 촬영 방식 |
| 유사한 식생 질감·개체 차이 | 범주 정의와 영상에서 구별할 단서가 맞는가 | 라벨 기준, 혼동한 범주 |
밝기나 잘라내기 등을 바꾸어 학습 입력을 늘리는 **데이터 증강(data augmentation)**은 일부 관측 변화를 학습에 반영하는 방법이다. 탐지·분할 자료의 위치를 바꾸면 상자·마스크도 영상과 일치하게 변환해야 한다. 다만 색이 판단 근거인 과제에서 색을 무작정 바꾸거나, 대상 대부분을 잘라내고도 원래 라벨을 유지하면 다른 문제를 만들 수 있다. 합성한 변형이 실제 겨울 수관이나 가림 조건을 모두 대표하지도 않는다. 어떤 변화까지 대응할지는 해당 조건에서 얻은 평가 결과로 확인한다. TorchVision의 영상·상자·마스크 변환
4.9 성능을 어떻게 평가하는가
정답자료·평가 단위·자료 분리
**기준자료(reference data)**는 예측과 비교할 범주·위치·영역 등의 기록이다. AI 평가에서는 이를 정답자료 또는 ground truth라고 부르지만, 사람이 작성했다는 이유만으로 오류가 없는 것은 아니다. 수목 한 주를 무엇으로 구별했는지, 수관의 가려진 부분을 포함했는지, 어느 시점의 상태를 기록했는지를 먼저 정해야 한다.
평가 단위는 맞고 틀림을 세는 대상이다. 한 사진의 포장 종류를 분류하면 사진이나 잘라낸 영역이 단위가 된다. 객체 탐지에서는 객체 후보와 기준 객체의 대응을, 의미 분할에서는 픽셀의 범주를 비교한다. 추적은 여러 프레임 사이의 동일 대상 연결도 평가해야 한다. 프레임별 탐지 성능만으로 추적 ID의 정확성을 대신할 수는 없다.
자료를 나누는 목적도 다르다. **학습자료(training set)**는 매개변수를 배우는 데 사용한다. **검증자료(validation set)**는 모델·설정·임곗값을 고르는 데 사용한다. **시험자료(test set)**는 그렇게 정한 방법을 최종적으로 평가할 때 남겨 두는 자료다. 시험 결과를 보며 반복해서 설정을 고르면, 그 자료는 사실상 방법을 고르는 데 사용된 셈이다. 학습·검증·시험 자료의 구별
공원 영상에는 가까운 위치에서 연속 촬영한 사진이 많다. 같은 수목의 거의 같은 모습이 학습과 시험 양쪽에 들어가면 새 대상을 인식하는 능력보다 익숙한 장면을 다시 맞히는 능력을 평가할 수 있다. 이러한 정보의 섞임을 데이터 누출(data leakage) 관점에서 살핀다. 원 영상에서 잘라낸 조각이나 증강본은 원본과 함께 묶어 분리하는 것이 기본이다.
무엇을 평가하려는지에 따라 분리 기준을 선택한다. 새 공원에 적용하려면 장소를, 같은 공원의 이후 시점에 적용하려면 시간을 나누어 평가한다. 새 수목 개체에 대한 성능이 궁금하다면 같은 개체의 반복 관측이 양쪽에 섞이지 않도록 한다. scikit-learn의 그룹 분리 방식도 같은 그룹이 학습과 시험에 함께 들어가지 않도록 설계되어 있다. 그룹·시간에 따른 자료 분리
정확도: 전체 중 얼마나 맞혔는가
**정확도(Accuracy)**는 평가한 항목 전체 중 맞힌 항목의 비율이다. 아래에서는 수목 한 주에 대응하는 기록 하나를 평가 단위로 정한다. 설명을 위해 100개 기록 중 고사 2개, 정상 98개라는 기준 라벨을 직접 만들었다. 이는 공통 가상 공원의 실제 수목 수나 고사 비율과 관계없는 별도의 산술 예다. 정확도의 정의
모든 기록을 정상이라고 예측하면 정상 98개는 맞히고 고사 2개는 놓친다. 정확도는 98/100, 즉 98%다. 그러나 고사목을 찾아 검토하는 목적에는 필요한 두 대상을 하나도 찾지 못했다. 이런 클래스 불균형(class imbalance) 상황에서는 다수 범주의 결과가 전체 정확도를 지배할 수 있다.
맞고 틀린 내용을 더 나누려면 먼저 관심 범주인 **양성(positive)**을 정한다. 이 예의 양성은 ‘고사’이며, 나머지인 ‘정상’이 음성이다. 양성이라는 말이 좋은 상태를 뜻하는 것은 아니다.
| 기준자료와 예측의 관계 | 이름 | 이 예에서의 의미 |
|---|---|---|
| 기준 고사 → 고사 예측 | 참양성 · TP | 찾아낸 고사목 |
| 기준 정상 → 고사 예측 | 거짓양성 · FP | 잘못 경고한 정상목 |
| 기준 고사 → 정상 예측 | 거짓음성 · FN | 놓친 고사목 |
| 기준 정상 → 정상 예측 | 참음성 · TN | 정상으로 맞힌 수목 |
이 네 수를 행과 열로 정리한 것이 **혼동행렬(confusion matrix)**이다. 행이 기준인지 예측인지 표에 밝혀야 한다. 아래 비교는 같은 기준자료에 두 가지 설명용 예측을 부여한 결과다. 실제 학습된 모델 두 개를 비교한 것이 아니다.
| 설명용 예측 | TP | FP | FN | TN | 정확도 | 고사 정밀도 | 고사 재현율 |
|---|---|---|---|---|---|---|---|
| 모두 정상 | 0 | 0 | 2 | 98 | 98% | 정의되지 않음 | 0% |
| 고사 2개와 정상 3개를 고사로 표시 | 2 | 3 | 0 | 95 | 97% | 40% | 100% |
정밀도와 재현율: 잘못 찾은 것과 놓친 것
**정밀도(Precision)**는 양성으로 예측한 것 중 실제 양성이 차지하는 비율이다. ‘고사라고 표시한 것들을 검토하면 얼마나 맞는가’라는 질문이다. 두 번째 예측에서는 고사로 표시한 5개 중 2개가 기준 고사이므로 40%다.
**재현율(Recall)**은 기준자료의 양성 중 찾아낸 비율이다. ‘찾아야 할 고사목을 얼마나 놓치지 않았는가’라는 질문이다. 같은 예에서는 기준 고사 2개를 모두 찾아 100%다.
두 식의 TP·FP·FN은 이 예에서 수목 기록의 개수이며 비율에는 단위가 없다. 모든 대상을 정상으로 예측한 첫 번째 경우에는 양성 예측 자체가 없어 정밀도의 분모가 0이다. 이를 높은 정밀도로 해석하지 않는다. 도구가 분모 0인 경우에 채우는 0 등의 대체값과, 수학적으로 정의되지 않는 상태를 구별해야 한다. 정밀도·재현율과 분모 0의 처리
두 번째 예측은 고사목을 놓치지 않았지만 정상목 세 개를 추가로 검토하게 한다. 정확도만 보면 첫 번째가 높아도, 두 결과가 만드는 업무는 다르다. 놓침과 추가 검토가 각각 어떤 결과를 가져오는지 판단해야 하며 이 작은 표로 특정 예측을 현장에 채택할 수는 없다. 특히 양성이 두 개뿐이면 하나를 더 놓치는 것만으로 재현율이 50%포인트 달라진다. 비율과 함께 실제 개수를 남기는 이유다.
IoU와 Dice: 예측한 영역이 얼마나 겹치는가
4.5에서 마스크는 픽셀별 영역 기록이라고 설명했다. **IoU(Intersection over Union)**는 기준 영역과 예측 영역이 겹치는 부분을, 둘 중 하나라도 포함하는 전체 영역으로 나눈 값이다. 집합의 교집합과 합집합을 비교하며 자카드 지수(Jaccard index)라고도 한다. 상자의 면적이나 마스크의 픽셀 집합에 적용할 수 있지만, 무엇을 비교했는지 구별한다. IoU에 해당하는 자카드 지수의 정의
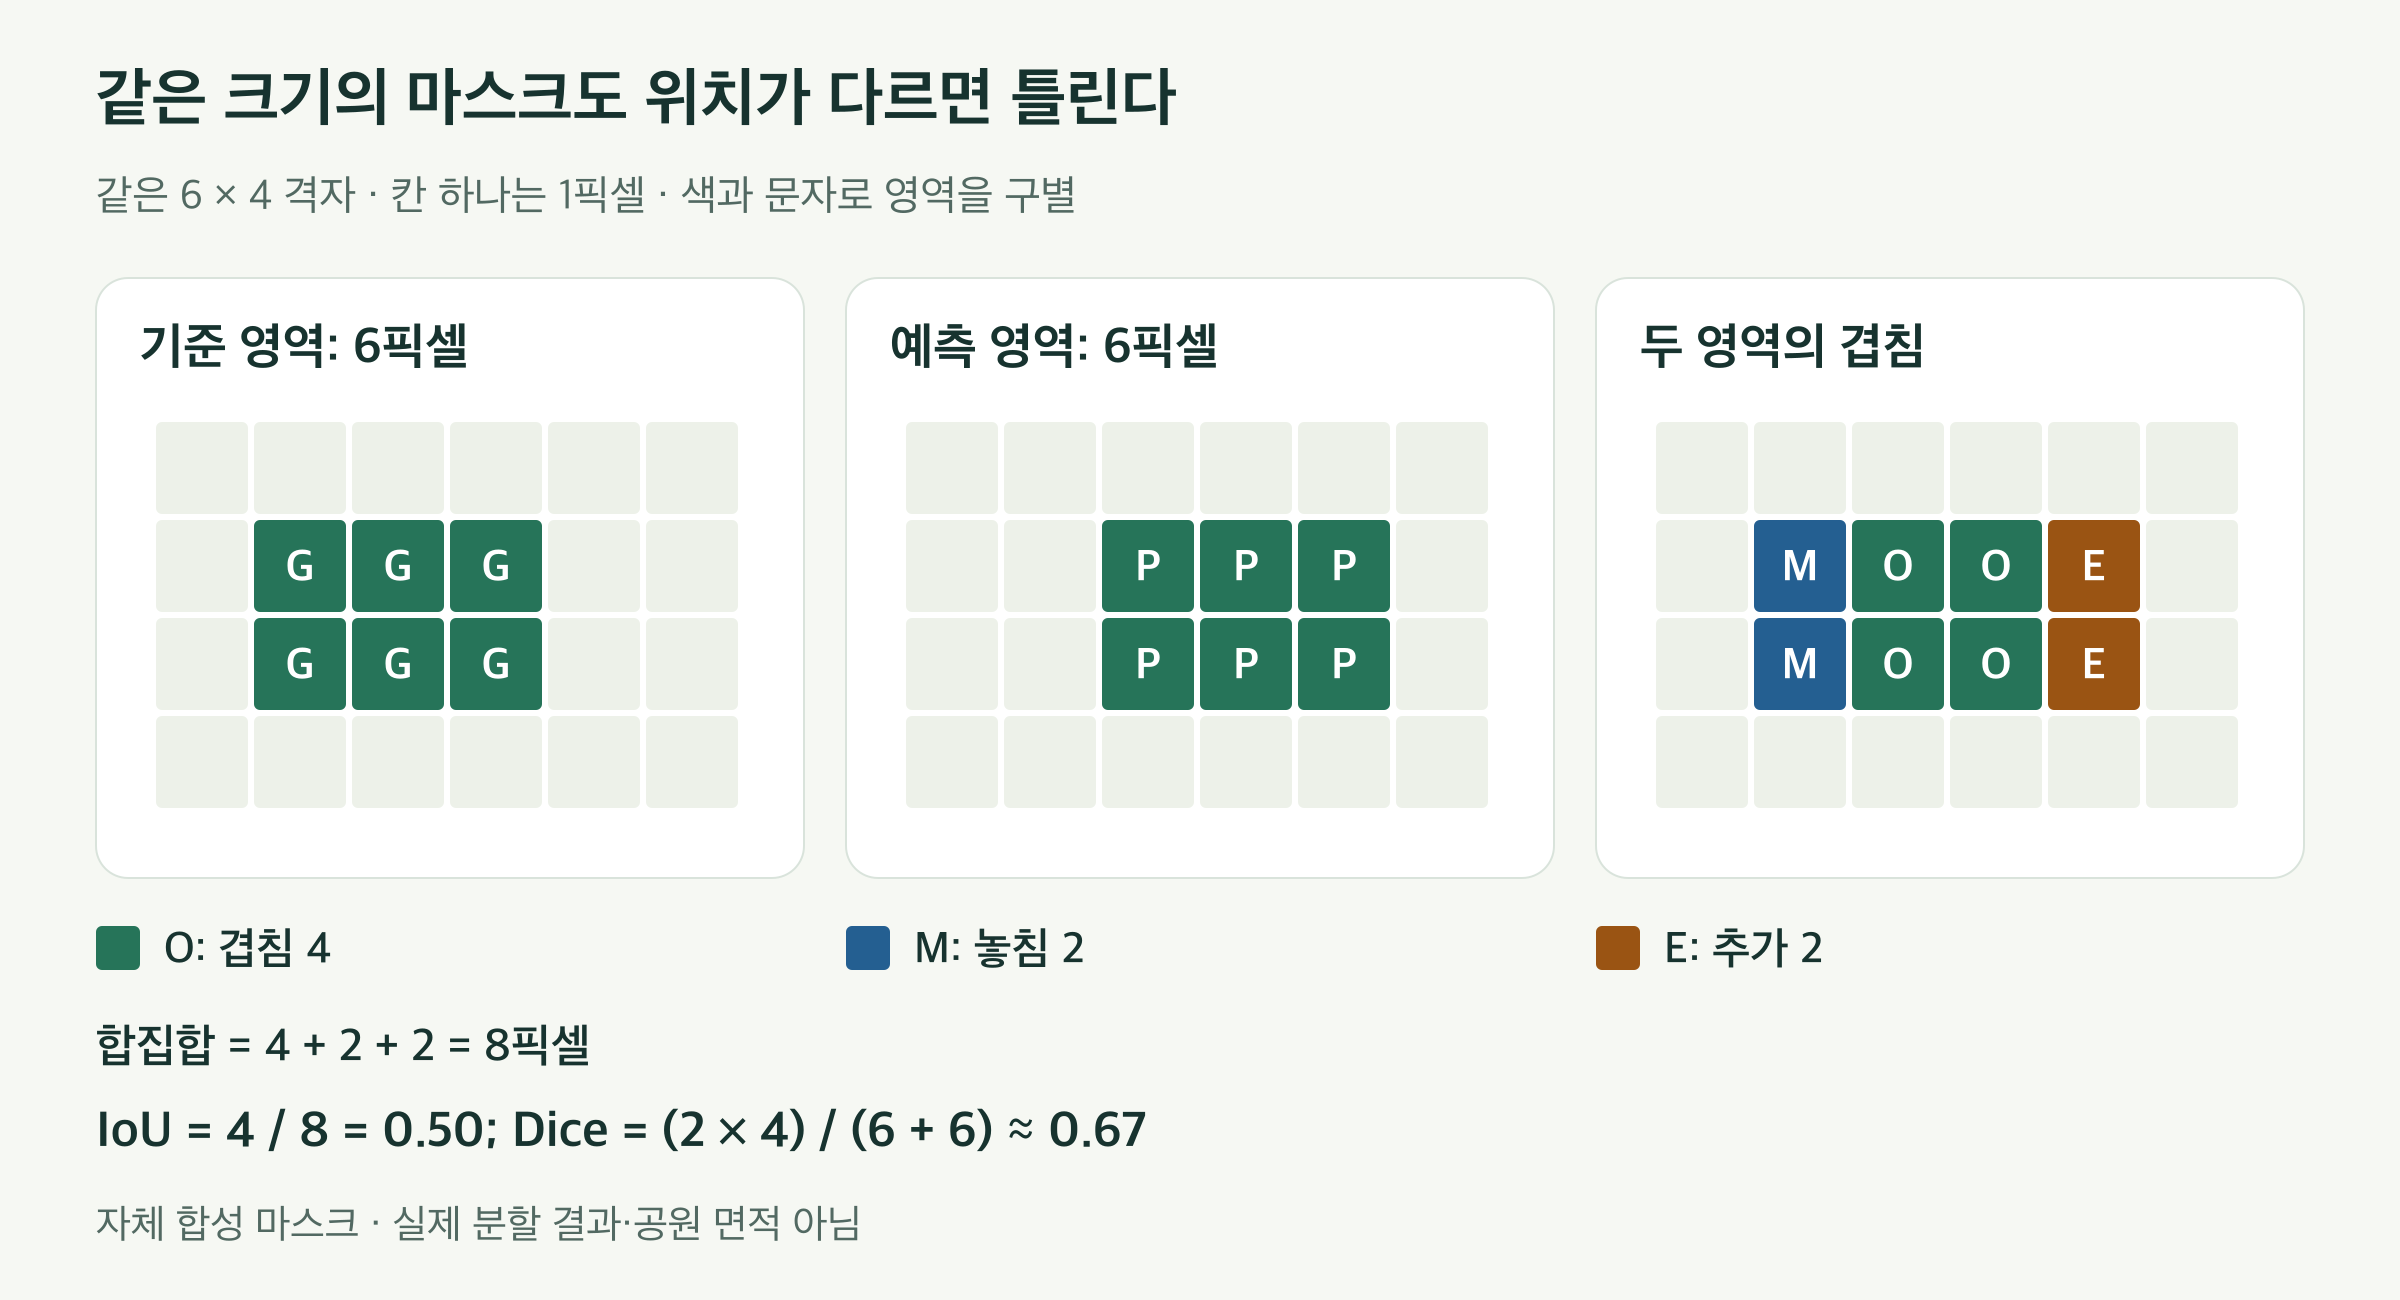
같은 6×4 격자에 기준 마스크와 예측 마스크를 6픽셀씩 표시한다. 두 영역이 겹치는 픽셀은 4개, 기준에만 있는 픽셀은 2개, 예측에만 있는 픽셀은 2개다. 합집합은 8픽셀이므로 IoU는 0.50이며 Dice는 8을 12로 나눈 약 0.67이다.
그림. 마스크의 크기가 같아도 위치가 다르면 완전히 맞지 않는다. 자체 합성 격자이며 각 칸은 한 픽셀이다. G는 기준, P는 예측 영역이다. 겹침 4칸·놓침 2칸·추가 2칸을 색과 문자로 구별했다. 실제 공원 면적이나 모델 분할 결과가 아니다.
그림에서는 기준과 예측이 각각 6픽셀이고, 겹치는 것은 4픽셀이다. 둘 중 하나라도 포함하는 영역은 6+6−4=8픽셀이므로 IoU=4/8=0.50이다. 예측 면적이 기준 면적과 같다는 사실만으로 위치까지 맞는 것은 아니라는 점도 확인할 수 있다.
Dice 계수는 겹침을 두 배 한 값을 기준 영역 크기와 예측 영역 크기의 합으로 나눈다. 이 예에서는 Dice=(2×4)/(6+6)=약 0.67이다. 같은 두 마스크의 겹침을 다른 방식으로 정규화하므로 IoU와 Dice의 숫자는 직접 같은 기준으로 비교하지 않는다. Dice의 정의와 집계 조건
포장·수관·초본 식재지의 영역을 평가한다면 범주별 값도 살펴야 한다. 큰 배경 영역을 잘 맞혔다는 이유로 작은 배수시설의 누락이 가려질 수 있다. 범주별 값을 같은 비중으로 평균하는 매크로 평균과, 전체 픽셀의 수를 합쳐 계산하는 마이크로 방식은 다른 질문에 답한다. 이미지별로 계산해 평균할지, 여러 이미지의 픽셀을 먼저 합칠지도 구별한다. 배경 포함 여부와 기준·예측 모두 비어 있는 범주의 처리까지 기록해야 비교가 가능하다. 분할 지표의 평균·배경 설정
탐지 평가: 상자 수와 맞힌 객체 수는 다르다
탐지에서는 범주와 위치가 함께 맞아야 한다. 여기서는 한 영상·한 범주에 대해, 점수가 높은 예측부터 같은 범주의 아직 대응되지 않은 기준 객체 중 IoU가 가장 큰 것을 찾는 간단한 규칙을 사용한다. IoU가 정한 기준 이상이면 TP로 센다. 하나의 기준 객체는 한 번만 대응시키므로, 같은 객체에 대한 두 번째 상자는 중복 FP가 될 수 있다. COCO 평가 구현에서도 일반 객체가 이미 대응되었으면 다시 대응시키지 않는 처리를 확인할 수 있다. 군중·평가 제외 영역 등 별도 규칙은 이 작은 예에서 사용하지 않는다. COCO 공식 탐지 평가 구현
아래는 기준 객체 3개와 예측 상자 6개를 직접 정한 예다. IoU 대응 기준은 0.50이고, 점수 이상인 예측을 남기도록 정했다. 점수는 설명용 숫자로 실제 모델의 confidence나 확률이 아니다.
| 점수순 예측 | 직접 정한 점수 | IoU 0.50에서의 대응 결과 | 여기까지 남길 때 정밀도 | 여기까지 남길 때 재현율 |
|---|---|---|---|---|
| D1 | 0.95 | G1에 대응 · TP | 1/1 = 100% | 1/3 ≈ 33.3% |
| D2 | 0.90 | G1의 중복 상자 · FP | 1/2 = 50% | 1/3 ≈ 33.3% |
| D3 | 0.80 | G2에 대응 · TP | 2/3 ≈ 66.7% | 2/3 ≈ 66.7% |
| D4 | 0.60 | 대응할 기준 객체 없음 · FP | 2/4 = 50% | 2/3 ≈ 66.7% |
| D5 | 0.50 | G3에 대응 · TP | 3/5 = 60% | 3/3 = 100% |
| D6 | 0.30 | 대응할 기준 객체 없음 · FP | 3/6 = 50% | 3/3 = 100% |
**점수 임곗값(score threshold)**은 어떤 예측을 남길지 정한다. IoU 임곗값은 남긴 상자의 위치가 기준 객체와 얼마나 겹쳐야 맞은 것으로 인정할지 정한다. 이름에 같은 숫자 0.50이 쓰여도 의미가 다르다. 위 예의 D3는 G2와 IoU가 약 0.67이어서 IoU 기준 0.50에서는 TP지만, 0.75로 높이면 대응되지 않는다. 점수 0.80이 바뀌지 않아도 평가 결과는 달라진다.
AP와 mAP: 한 임곗값을 넘어 평가하기
점수 임곗값을 내리면 더 많은 예측이 남는다. 위처럼 고정된 예측 목록을 순서대로 추가하는 조건에서는 찾아낸 기준 객체 수가 줄어들지 않아 재현율은 유지되거나 증가한다. 정밀도는 새 예측이 맞는지에 따라 내려가거나 올라간다. 이 관계를 나타내는 것이 **정밀도–재현율 곡선(PR curve)**이다.
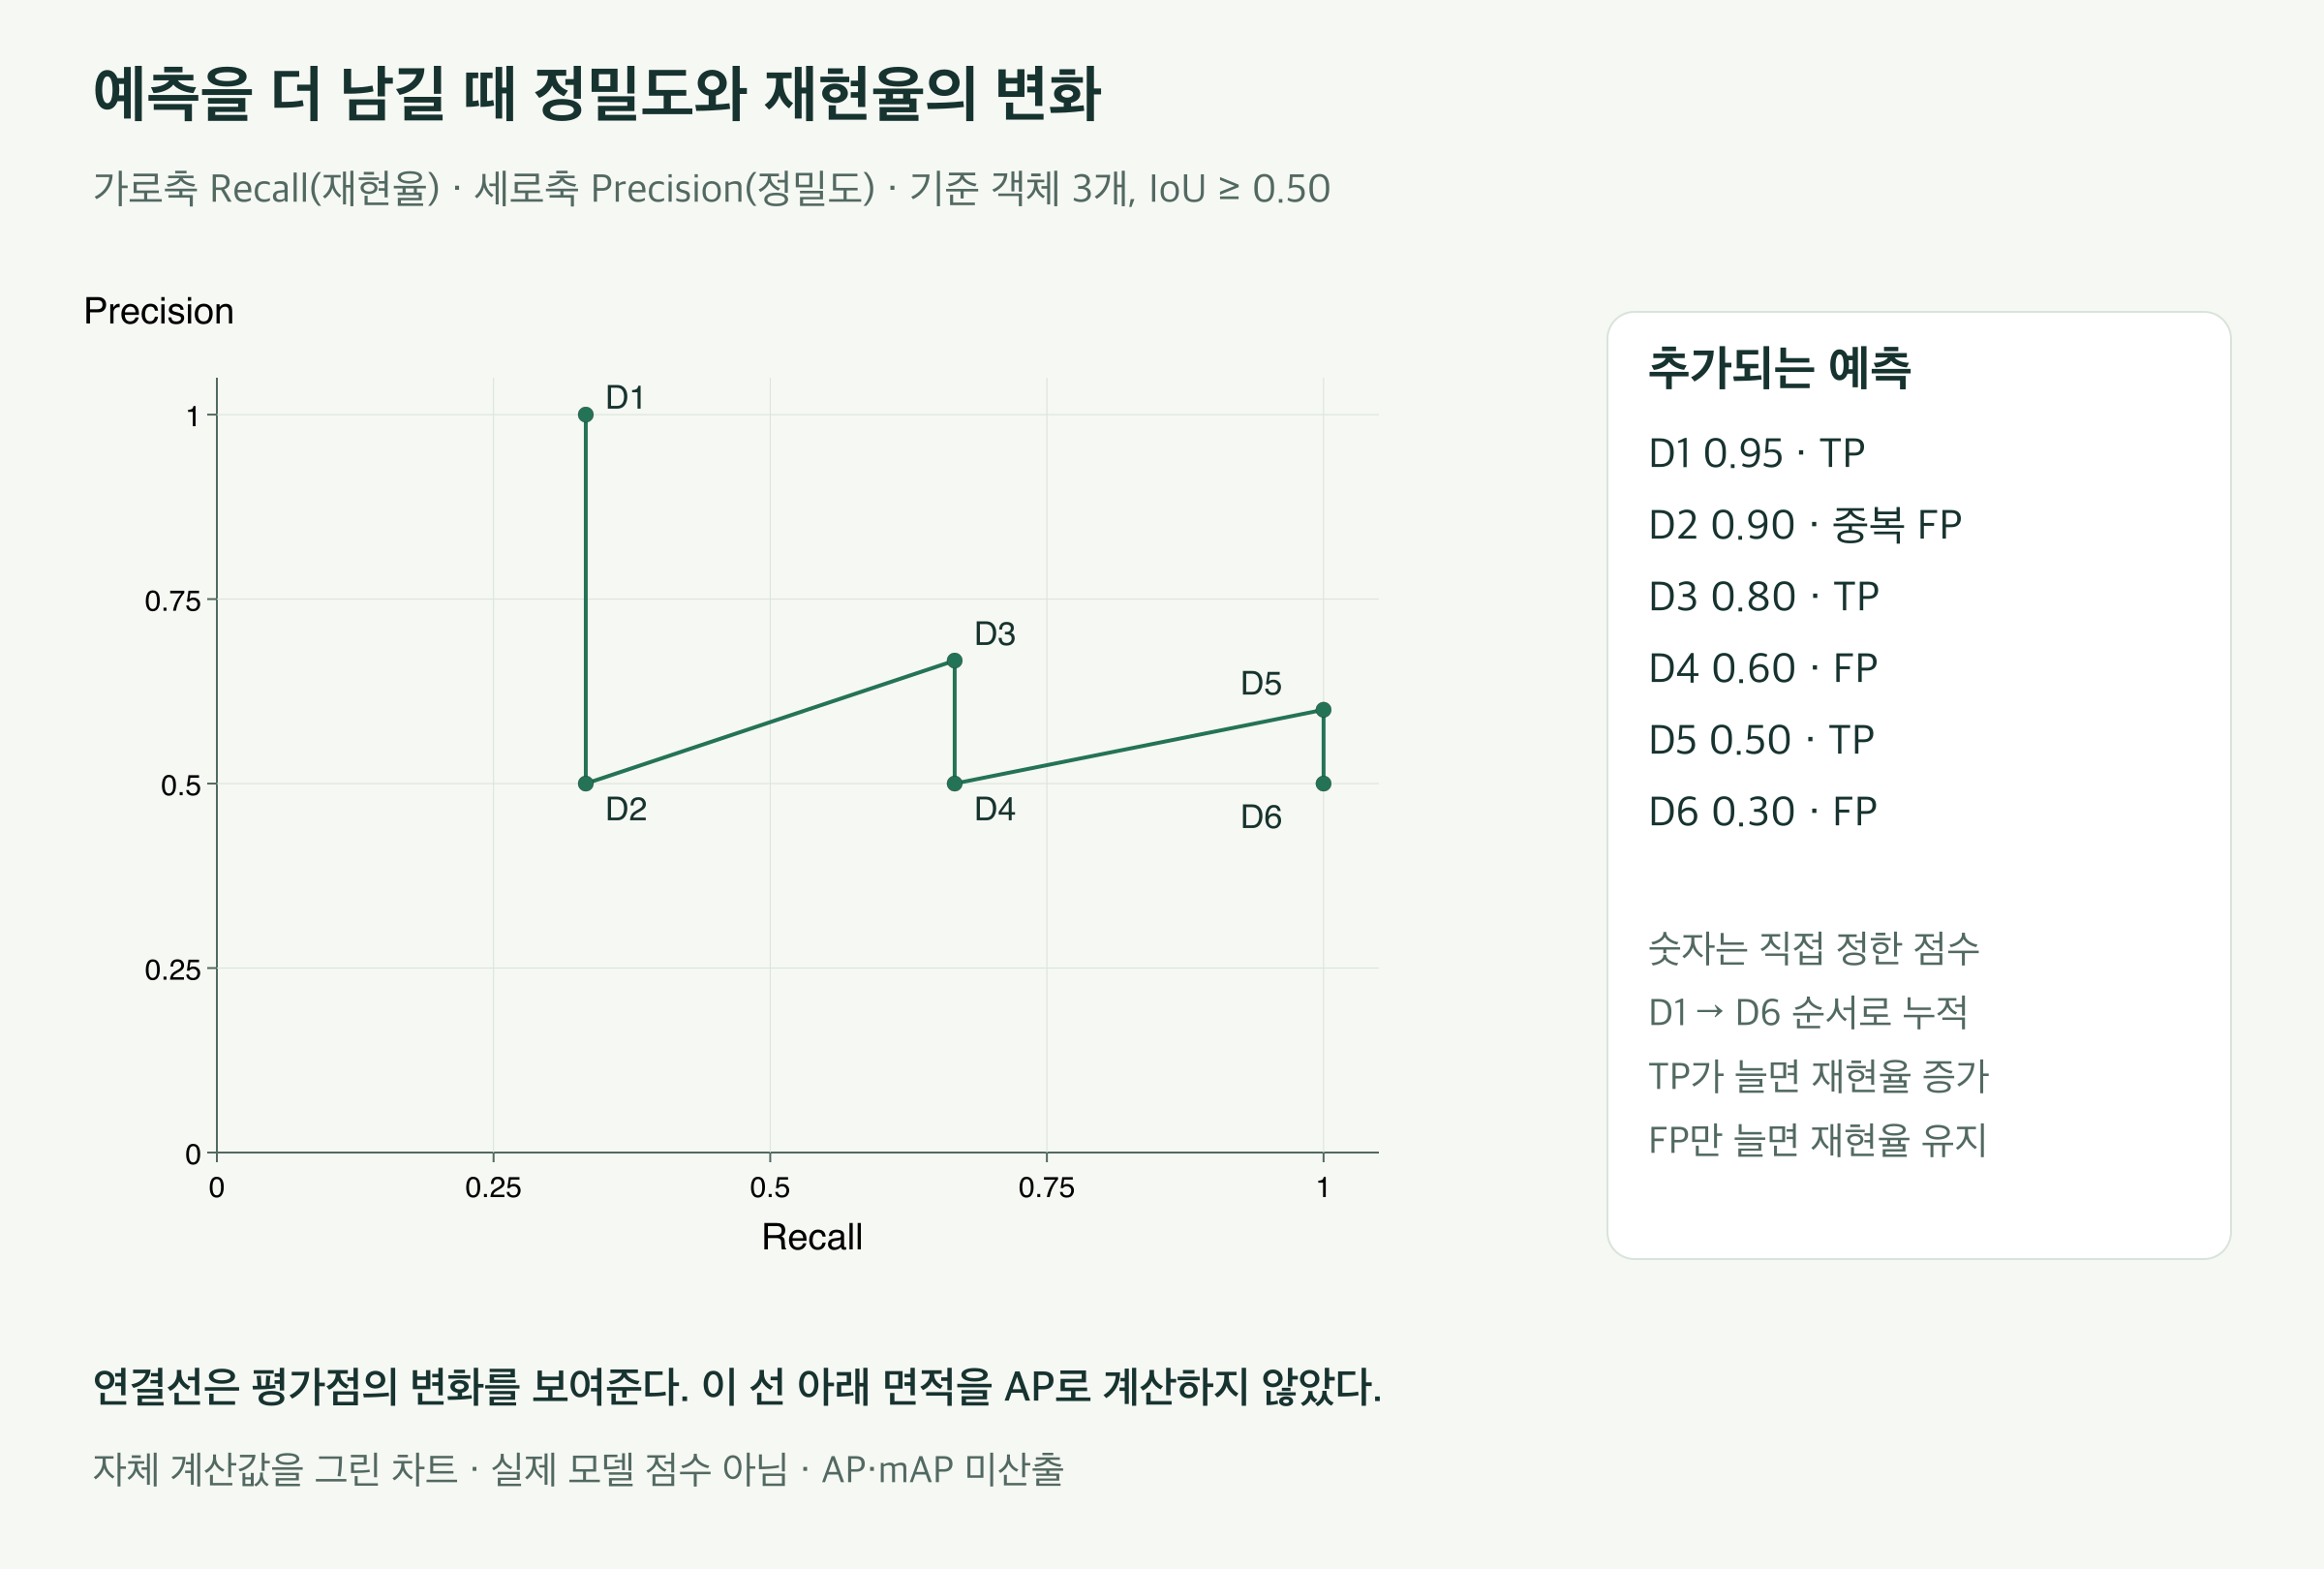
가로축 재현율, 세로축 정밀도로 여섯 예측을 점수순으로 추가한 결과를 표시한다. D1은 재현율 약 0.33과 정밀도 1, D2는 같은 재현율과 정밀도 0.5다. D3부터 D6까지 기준 객체를 추가로 찾거나 FP가 늘면서 점이 이동한다. 선은 표의 누적점을 잇는 것이며 AP 보간 곡선은 아니다.
그림. 점수 기준을 낮추며 얻은 여섯 누적 평가점. 앞 표의 자체 계산값을 표준 차트 도구로 그렸다. D1→D6은 예측을 더 남기는 순서다. 연결선은 점의 변화를 보여주기 위한 것이며 이 선 아래 면적을 AP로 계산하지 않았다.
**AP(Average Precision)**는 한 범주에 대해 재현율 범위 전반의 정밀도를 정해진 규칙으로 요약한 값이다. 임의로 고른 몇 점의 정밀도를 단순 평균하는 것과는 다르다. 어떤 재현율 지점에서 어떤 보간을 사용하는지에 따라 계산 규칙이 달라질 수 있다. **mAP(mean Average Precision)**는 여러 범주의 AP를 평균한 지표다.
COCO의 대표 탐지 AP는 0.50부터 0.95까지 0.05 간격인 열 개 IoU 기준을 사용하며 범주와 재현율 지점에 걸쳐 집계한다. 같은 체계의 AP50은 IoU 0.50 조건을 가리킨다. 보고서에서 AP 또는 mAP라는 이름을 보았다면 상자인지 마스크인지, IoU 범위, 범주, 객체 크기 범위와 이미지당 최대 예측 수를 함께 확인해야 한다. COCO의 기본 매개변수와 AP 집계
이 단위에서 직접 계산한 것은 혼동행렬의 비율, 마스크 겹침, 상자의 IoU와 대응, 여섯 PR 평가점이다. AP·mAP는 개념과 조건을 설명했으며 COCO 평가기를 실행하거나 점수를 산출하지 않았다. AP가 0.70이라는 수치를 ‘객체 70%를 찾았다’로 바꾸어 읽어서도 안 된다.
평가표에 남겨야 할 조경 조건
같은 모델의 전체 점수만 비교하기보다, 목적과 연결되는 부분을 나누어 읽는다. 수목과 시설물의 차이, 그늘과 양지의 차이, 가림 유무, 대상이 작게 보이는 조건을 살펴볼 수 있다. 각 조건의 자료 수가 적다면 그 값으로 일반적인 우열을 단정하지 않는다. 평균이 좋아도 실제 업무에서 중요한 작은 집수정을 자주 놓치는지 확인할 필요가 있다.
| 평가표의 항목 | 기록할 내용 |
|---|---|
| 질문과 단위 | 포장 종류 분류, 개별 수목 탐지, 수관 픽셀 분할 등 |
| 기준자료 | 작성 기준·시점, 확인한 사람·방법, 평가에서 제외한 영역 |
| 자료 구성 | 장소·계절·촬영 조건, 범주별 기준 객체 또는 픽셀 수 |
| 분리 기준 | 원 영상·개체·장소·시간 중 무엇을 함께 묶거나 나누었는가 |
| 모델과 설정 | 모델·처리 버전, 입력 크기, 점수 기준, 후처리 |
| 지표 조건 | 양성 범주, IoU 기준, 평균 방식·배경·빈 범주 처리 |
| 결과와 실패 | 전체·조건별 값, 놓침·중복·오경고, 검토한 실패 영상 |
이렇게 평가하면 ‘성능이 좋다’는 말을 어떤 대상과 조건에서 무엇을 잘했는지로 바꿀 수 있다. 다음 단위에서는 좋은 평균 성능을 얻었더라도 개별 결과가 틀릴 수 있는 이유와, 언제 판단을 보류하고 사람의 검토로 넘길지 설명한다.
이 단위의 수목 라벨·마스크·상자·점수는 자체 설명용이다. 계산 자료와 출처 및 열람 범위를 별도로 남겼다. 실제 모델의 학습·현장 추론·성능 실험 결과가 아니다.
6단위. 불확실한 결과를 다루고 같은 장면을 비교하기
4장 6단위 · 4.10–4.12 · v0.1 검토용 초고
앞 단위에서는 모델의 결과를 기준자료와 비교했다. 이제 남은 질문은 개별 결과를 업무에 어떻게 사용할지다. 평균 성능이 좋아도 특정 집수정을 놓칠 수 있고, 높은 점수를 붙인 포장 종류가 틀릴 수도 있다. 인식 결과를 자동으로 정리하려면 범주·상자·마스크와 함께 판단의 근거가 충분한지, 어떤 결과를 보류할지, 무엇을 다시 확인할지를 다루어야 한다.
4.10 불확실성과 실패
Confidence는 무엇을 나타내는가
시각 AI의 결과에는 수목 · confidence 0.96과 같은 값이 붙을 수 있다. Confidence는 모델이 자신의 예측에 부여한 점수다. 분류에서는 선택한 범주의 출력 확률을 쓰기도 하지만, 탐지에서는 객체의 존재와 범주 등에 관련된 값이 사용될 수 있다. 따라서 먼저 해당 모델에서 점수를 어떻게 정의했는지 확인해야 한다. 같은 0.96이라도 다른 모델·과제의 점수를 그대로 비교할 수는 없다.
일반적인 다중 범주 분류에서 **소프트맥스(softmax)**는 범주별 원점수를 0과 1 사이로 바꾸고 합이 1이 되게 하는 함수다. 원점수를 로짓(logit)이라고 한다. 합이 1이라는 조건은 출력의 형식이지 현실에서의 정확성을 검증한 결과가 아니다. 미리 정한 범주 중 하나를 고르도록 만든 모델은 익숙하지 않은 대상에도 높은 값을 줄 수 있다. 0.96을 보았다는 이유만으로 그 수목의 존재·수종·건강 상태가 모두 96% 확실하다고 읽어서는 안 된다. 분류 출력과 신뢰도의 보정
점수와 실제 결과를 맞춰 보는 보정
**확률 보정(calibration)**은 예측 확률과 실제 결과의 빈도가 얼마나 잘 대응하는지 다루는 개념이다. 예를 들어 이진 분류에서 특정 범주에 약 0.8을 부여한 자료를 충분히 모았다면, 잘 보정된 예측에서는 그중 약 80%가 해당 범주에 속하기를 기대한다. 이는 비슷한 점수를 받은 자료 집단의 성질이다. 지금 보고 있는 한 장이 반드시 맞는다는 뜻은 아니다. 확률 보정의 정의
**신뢰도 도표(reliability diagram)**는 점수가 비슷한 자료를 구간으로 묶고, 구간의 평균 예측값과 실제 비율을 비교한다. 양성 범주의 확률을 평가하는지, 최종 선택한 범주의 점수와 정답률을 비교하는지에 따라 세는 대상이 다르다. 구간에 들어간 자료 수와 범주·계절·장소도 함께 살펴야 한다. 전체 자료에서 맞아 보이는 관계가 겨울 영상이나 작은 시설물에서도 유지되는지는 별도로 확인한다.
보정 방법은 이미 학습한 모델의 출력을 별도 자료로 조정할 수 있다. Guo 등의 연구가 설명한 **온도 스케일링(temperature scaling)**은 모든 범주의 로짓에 하나의 양의 조정값을 적용하는 방식이다. 한 입력 안에서 가장 큰 로짓의 범주는 유지되므로, 이 방식은 최상위 범주 자체를 바꾸지 않으면서 확률의 분포를 조정한다. 잘못 분류한 사진을 모두 올바르게 고치는 기술로 이해하면 안 된다. 온도 스케일링의 원리
보정에 사용하는 자료는 모델이 이미 학습한 자료와 구별하고, 보정 방법까지 정한 뒤의 평가는 다시 남겨 둔 자료에서 수행한다. 시험 결과에 맞추어 계속 조정하면 4.9에서 설명한 자료 분리의 의미가 사라진다. 현장 조건이 바뀌면 이전의 보정 관계도 재확인한다. 보정 자료를 분리하는 이유
입력이 부족한가, 배운 범위를 벗어났는가
**불확실성(uncertainty)**은 현재 가진 정보와 모델로 결과를 얼마나 확실하게 판단할 수 있는지의 문제다. Confidence 하나가 불확실성의 모든 원인을 알려 주지는 않는다. 영상의 경계가 흐린 경우와 모델이 낯선 대상을 만난 경우는 다음 행동도 다를 수 있다.
Kendall과 Gal은 관측에 내재한 잡음과 모델이 충분히 알지 못해 생기는 불확실성을 구별하여 다루었다. 전자는 흔히 데이터 불확실성(aleatoric uncertainty), 후자는 **모델 불확실성(epistemic uncertainty)**이라 부른다. 조경에서는 각각 흔들려 찍힌 잎의 경계와 학습자료에 부족했던 식생 형태를 생각해 볼 수 있다. 다만 한 사진의 오류 원인을 이 두 이름만으로 자동 진단할 수는 없다. 시각 AI에서 구별하는 불확실성
관측 조건을 고정하면 남는 잡음도, 촬영 방식이나 입력 정보를 바꾸면 달라질 수 있다. 가려진 집수정은 모델을 다시 학습하는 것보다 다른 위치에서 관측하는 편이 필요한 정보를 직접 줄 수 있다. 반대로 영상은 선명한데 특정 수종에서 계속 혼동한다면 범주 정의와 학습자료의 대표성을 먼저 살펴볼 수 있다. 이 구분은 어떤 기술에 투자할지 정하는 데 도움이 된다.
**분포 밖 입력(OOD, out-of-distribution)**은 기준으로 삼은 학습·개발 자료의 분포를 벗어난 입력을 뜻한다. 처음 보는 시설물 종류뿐 아니라, 기존 범주가 포함되어 있어도 전혀 다른 촬영 조건이 문제가 될 수 있다. 무엇을 분포 안으로 정의했는지가 먼저다. 새로운 장소의 사진을 모두 OOD라고 단정하거나, OOD가 아니라는 이유로 정답을 보증할 수는 없다.
Hendrycks와 Gimpel은 최대 소프트맥스 값을 이용해 오분류와 OOD 입력을 탐지하는 기초 방법을 제시했다. 낮은 점수를 검토 단서로 쓰는 접근이지만, 모든 낯선 입력이 낮은 점수를 내는 완전한 판별 규칙은 아니다. OOD 탐지에도 놓침과 잘못된 경고가 있어 별도 평가가 필요하다. 오분류·OOD 탐지의 기초 방법
판단 보류도 하나의 출력이다
**판단 보류(abstention)**는 현재 결과를 자동 채택하지 않고 추가 확인이 필요한 상태로 남기는 것이다. ‘대상이 없음’이나 ‘정상’이라는 범주와는 다르다. 집수정이 수목에 가려 보이지 않는다면 ‘집수정 없음’ 대신 ‘현재 영상으로 확인 불가’라는 상태가 필요할 수 있다.
이처럼 일부 입력만 선택하여 예측을 채택하는 접근을 **선택적 분류(selective classification)**라고 한다. 여기에는 함께 봐야 할 두 수가 있다. **채택률(coverage)**은 전체 입력 중 자동 채택한 비율이고, **채택 결과의 오류율(selective risk, 0–1 오류 기준)**은 채택한 결과 중 틀린 비율이다. 이 문맥의 coverage는 수관 피복률이나 촬영 범위를 뜻하지 않는다. 선택적 분류의 채택률과 오류율
포장 종류를 분류하는 기록 20개를 직접 만들었다고 하자. 높은 점수 구간의 8개 중 오답이 1개, 중간 구간의 6개 중 1개, 낮은 구간의 6개 중 3개가 오답이 되도록 설정했다. 같은 기록에서 점수 기준만 바꾼 산술 예다.
| 설명용 채택 규칙 | 채택한 수 | 그중 오답 | 채택률 | 채택 결과의 오류율 | 보류한 수 |
|---|---|---|---|---|---|
| 전부 채택 | 20 | 5 | 100% | 25% | 0 |
| 점수 0.75 이상 | 14 | 2 | 70% | 약 14.3% | 6 |
| 점수 0.90 이상 | 8 | 1 | 40% | 12.5% | 12 |
이 예에서는 엄격한 기준을 적용할수록 채택한 결과의 오류율이 낮아지지만, 사람이 확인할 수는 늘어난다. 높은 점수만 남긴 마지막 행에도 오답이 하나 있다. 실제 자료에서 기준을 올리면 오류율이 반드시 일정하게 낮아진다고 보장할 수도 없다. 이 표의 임곗값은 권장값이 아니며 실제 모델을 평가한 결과도 아니다. 앞 단위의 고사목 기록 100개와도 별개다.
어떤 기준을 쓸지는 오류의 영향과 확인 비용에 따라 달라진다. 포장 사진을 임시 폴더로 자동 정리하는 일과, 수목 제거 판단이나 시공 검측 기록을 확정하는 일은 오답의 결과가 다르다. ‘정답률이 높은 모델’이라는 정보만으로 같은 자동 처리 기준을 적용할 수 없다.
사람의 검토를 작업에 연결하기
**사람 참여형 처리(human-in-the-loop)**는 사람이 필요할 때 결과를 검토·수정하고 그 기록을 후속 처리에 연결하는 구조다. 사람에게 결과 화면을 보여 주는 것만으로 충분하지는 않다. 어떤 항목을 왜 검토하는지, 무엇을 확인했는지, 결정이 어디에 반영되는지가 정해져야 한다.
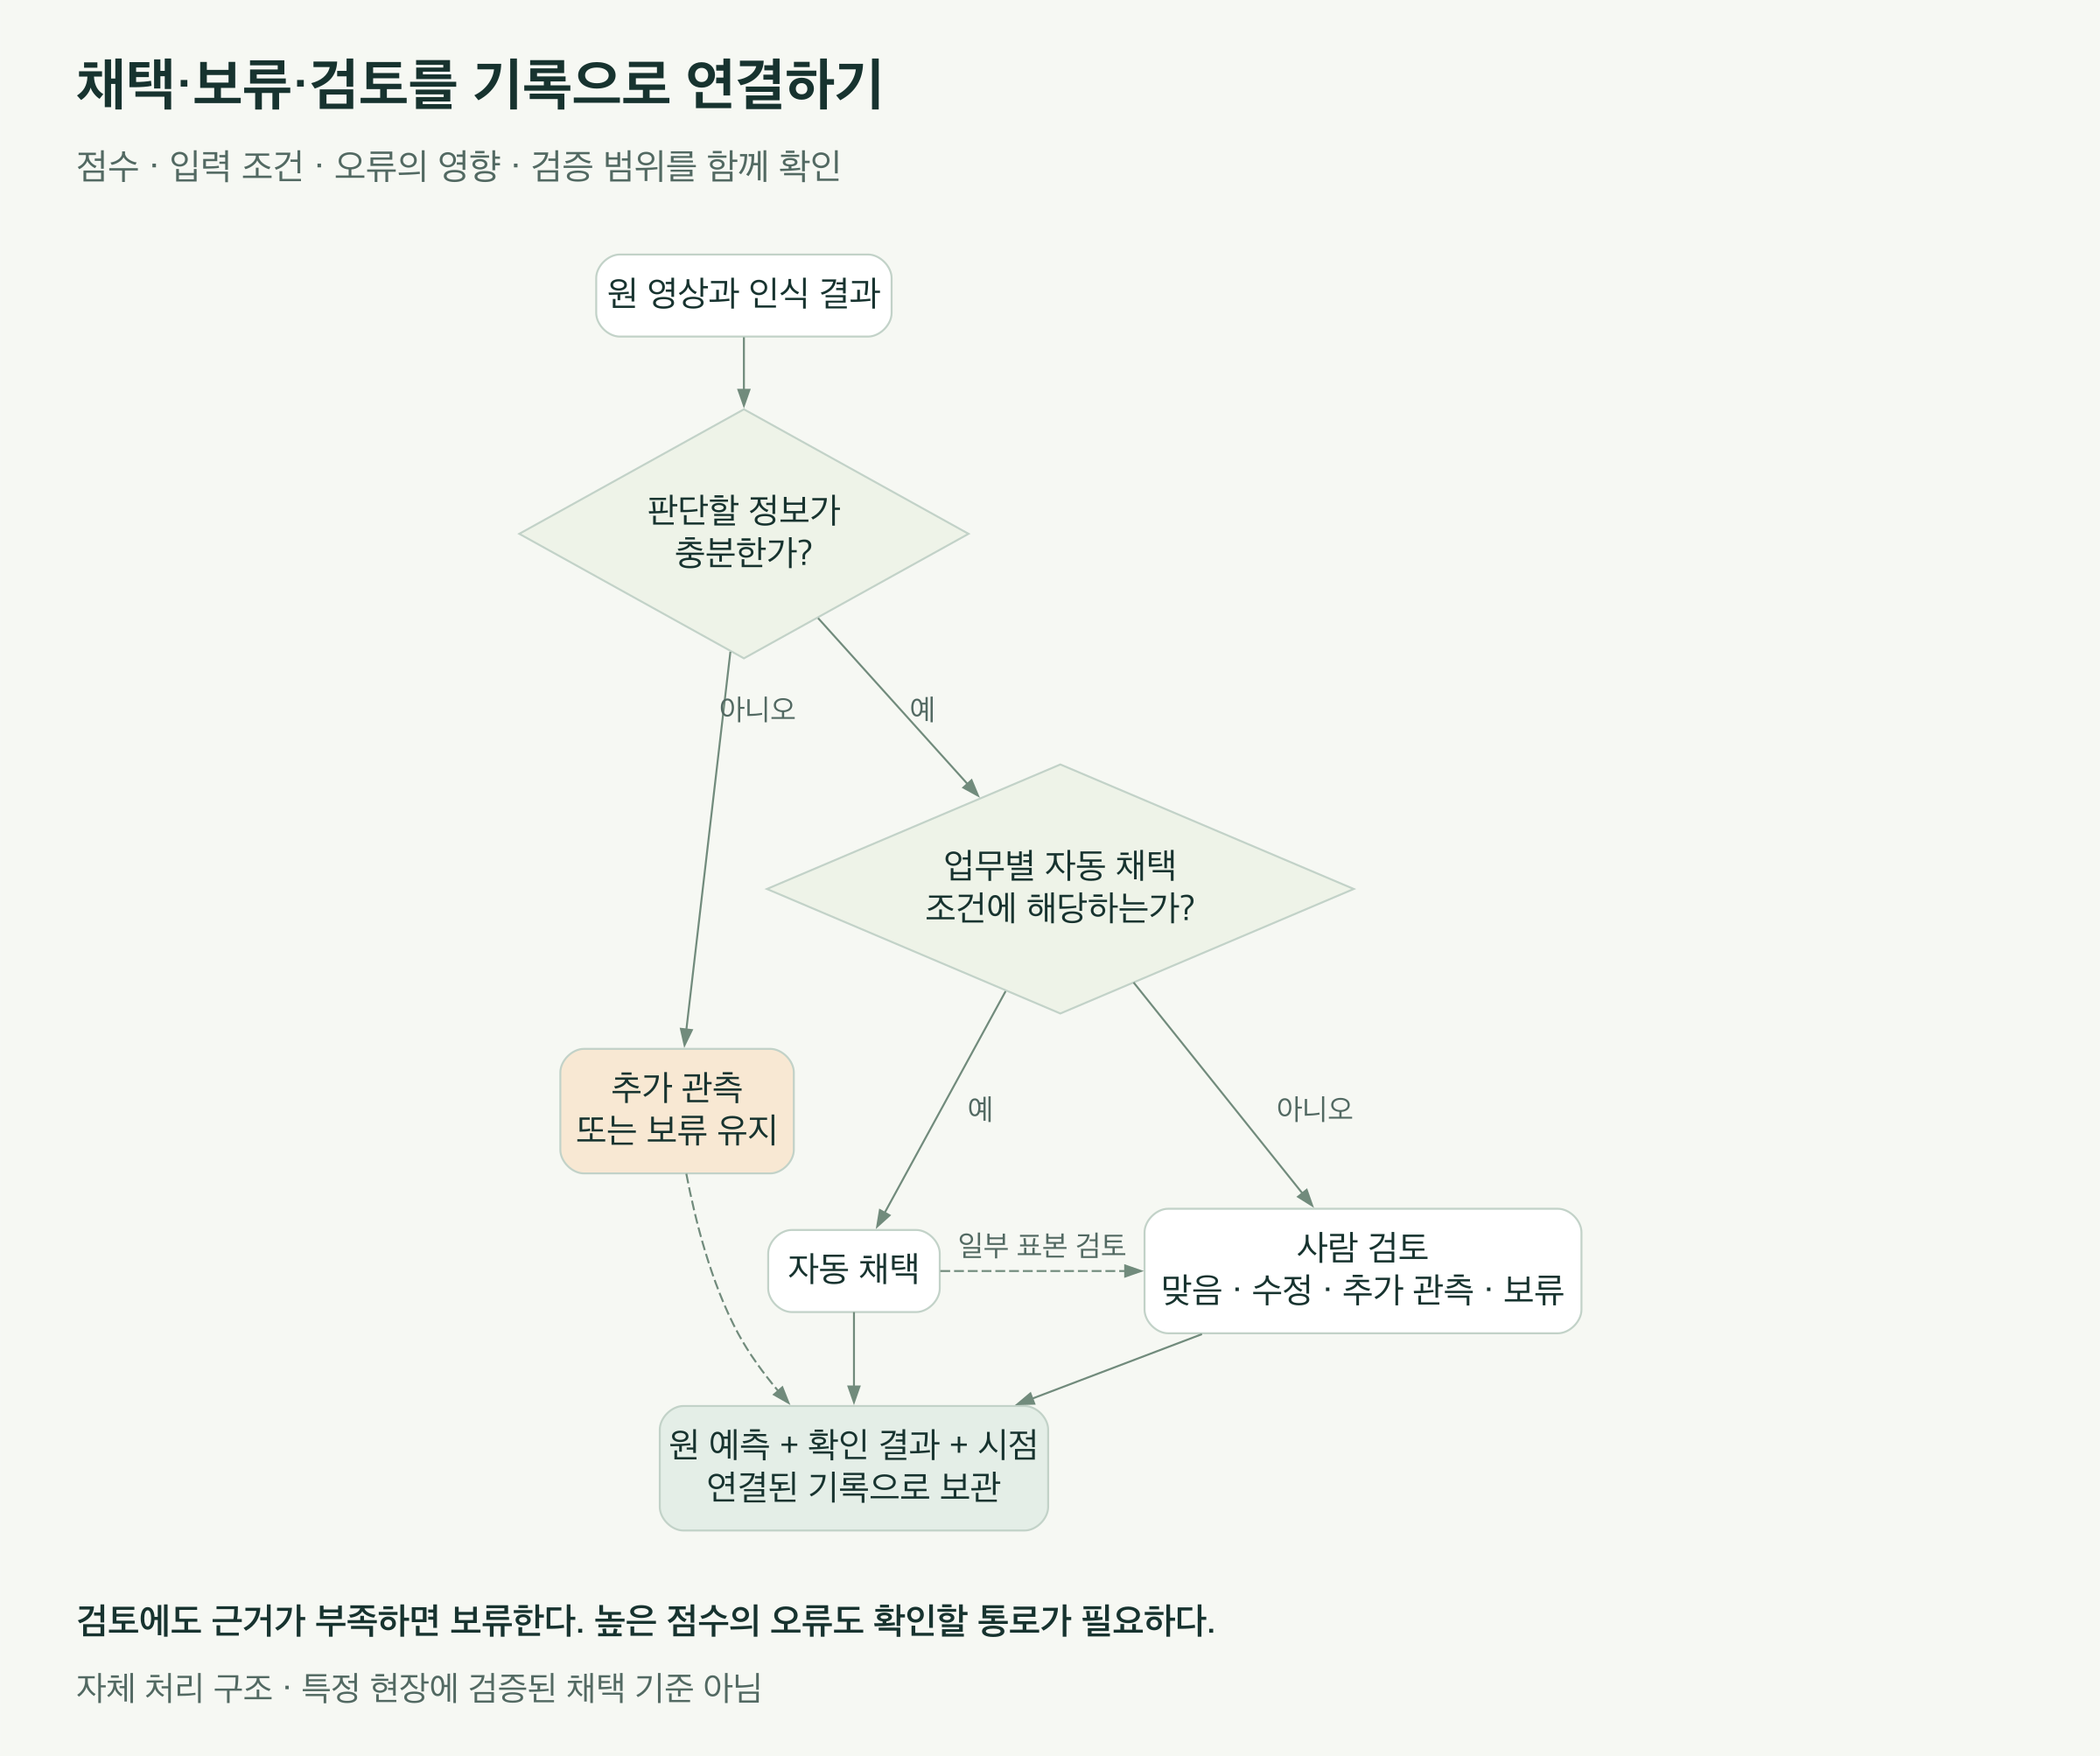
원 영상과 인식 결과에서 입력 조건과 업무 기준을 함께 확인한다. 정보가 부족하거나 검토 조건에 해당하면 추가 관측 또는 사람 검토로 보낸다. 자동 채택한 결과도 일부를 검토한다. 최종 기록에는 원 예측과 확인 내용이 함께 남는다.
그림. 결과를 채택하거나 보류한 뒤 기록으로 남기는 자체 처리 구조. 자동 채택에서도 표본 검토를 두며, 검토할 근거가 부족하면 보류를 유지한다. 특정 현장에 검증된 운영 규정은 아니다.
예를 들어 검토 화면에는 원 영상 ID, 촬영 시점, 해당 상자·마스크, 범주·점수, 확인 요청 이유를 함께 보여줄 수 있다. 검토자는 ‘맞음’, ‘수정’, ‘추가 관측’, ‘판단 보류’ 등을 기록한다. 수정한 결과가 원 예측을 조용히 덮어쓰지 않도록 두 값을 연결해 보관한다. 자동 채택한 결과의 표본도 확인해야 높은 점수로 통과한 오류를 발견할 기회가 생긴다.
이 과정에서 파일 누락·영상 크기·촬영 시점의 유무는 규칙으로 검사하고, 기준 미달 점수나 검토 대상 업무를 대기 목록으로 보내는 일을 자동화할 수 있다. 대기 목록에서 원 영상의 해당 위치를 바로 보여주면 사람이 다시 파일을 찾는 작업도 줄어든다. 다만 ‘판단할 정보가 충분한가’라는 질문 전체가 간단한 점수 검사로 해결되는 것은 아니다. 가림·라벨의 모호함 등은 별도의 확인 방식이 필요하다.
사람이 수정한 기록을 다음 학습에 활용하려면 라벨 기준을 다시 확인하고 시험자료와의 중복도 살펴야 한다. 검토 기록이 생겼다고 모델이 즉시 학습하거나 정확해지는 것은 아니다. 이러한 기록 구조는 10장의 설계검토, 12장의 상태 갱신, 13장의 행동 판단으로 이어진다.
4.11 같은 공원 장면을 다르게 인식하기
입력은 같고, 답의 형식이 달라진다
공통 가상 공원 D03에서 판석·블록 보행로, 초본 식재지, 수목 네 주, 벤치와 집수정이 포함된 일부를 자체 그림으로 표현했다. 실제 사진 대신 요소와 경계를 쉽게 비교할 수 있는 위에서 본 도식을 사용한다. 배치는 D03의 설계 좌표를 참조했지만, 수관·벤치·뚜껑의 표시 크기와 재질 무늬는 설명을 위해 직접 정했다.
아래 그림은 **동일한 입력 장면 SCENE-04-01**에 서로 다른 답을 붙인 것이다. 분류·탐지·분할을 순서대로 실행한 것이 아니며, 모든 출력은 사람이 정한 설명용 기록이다.
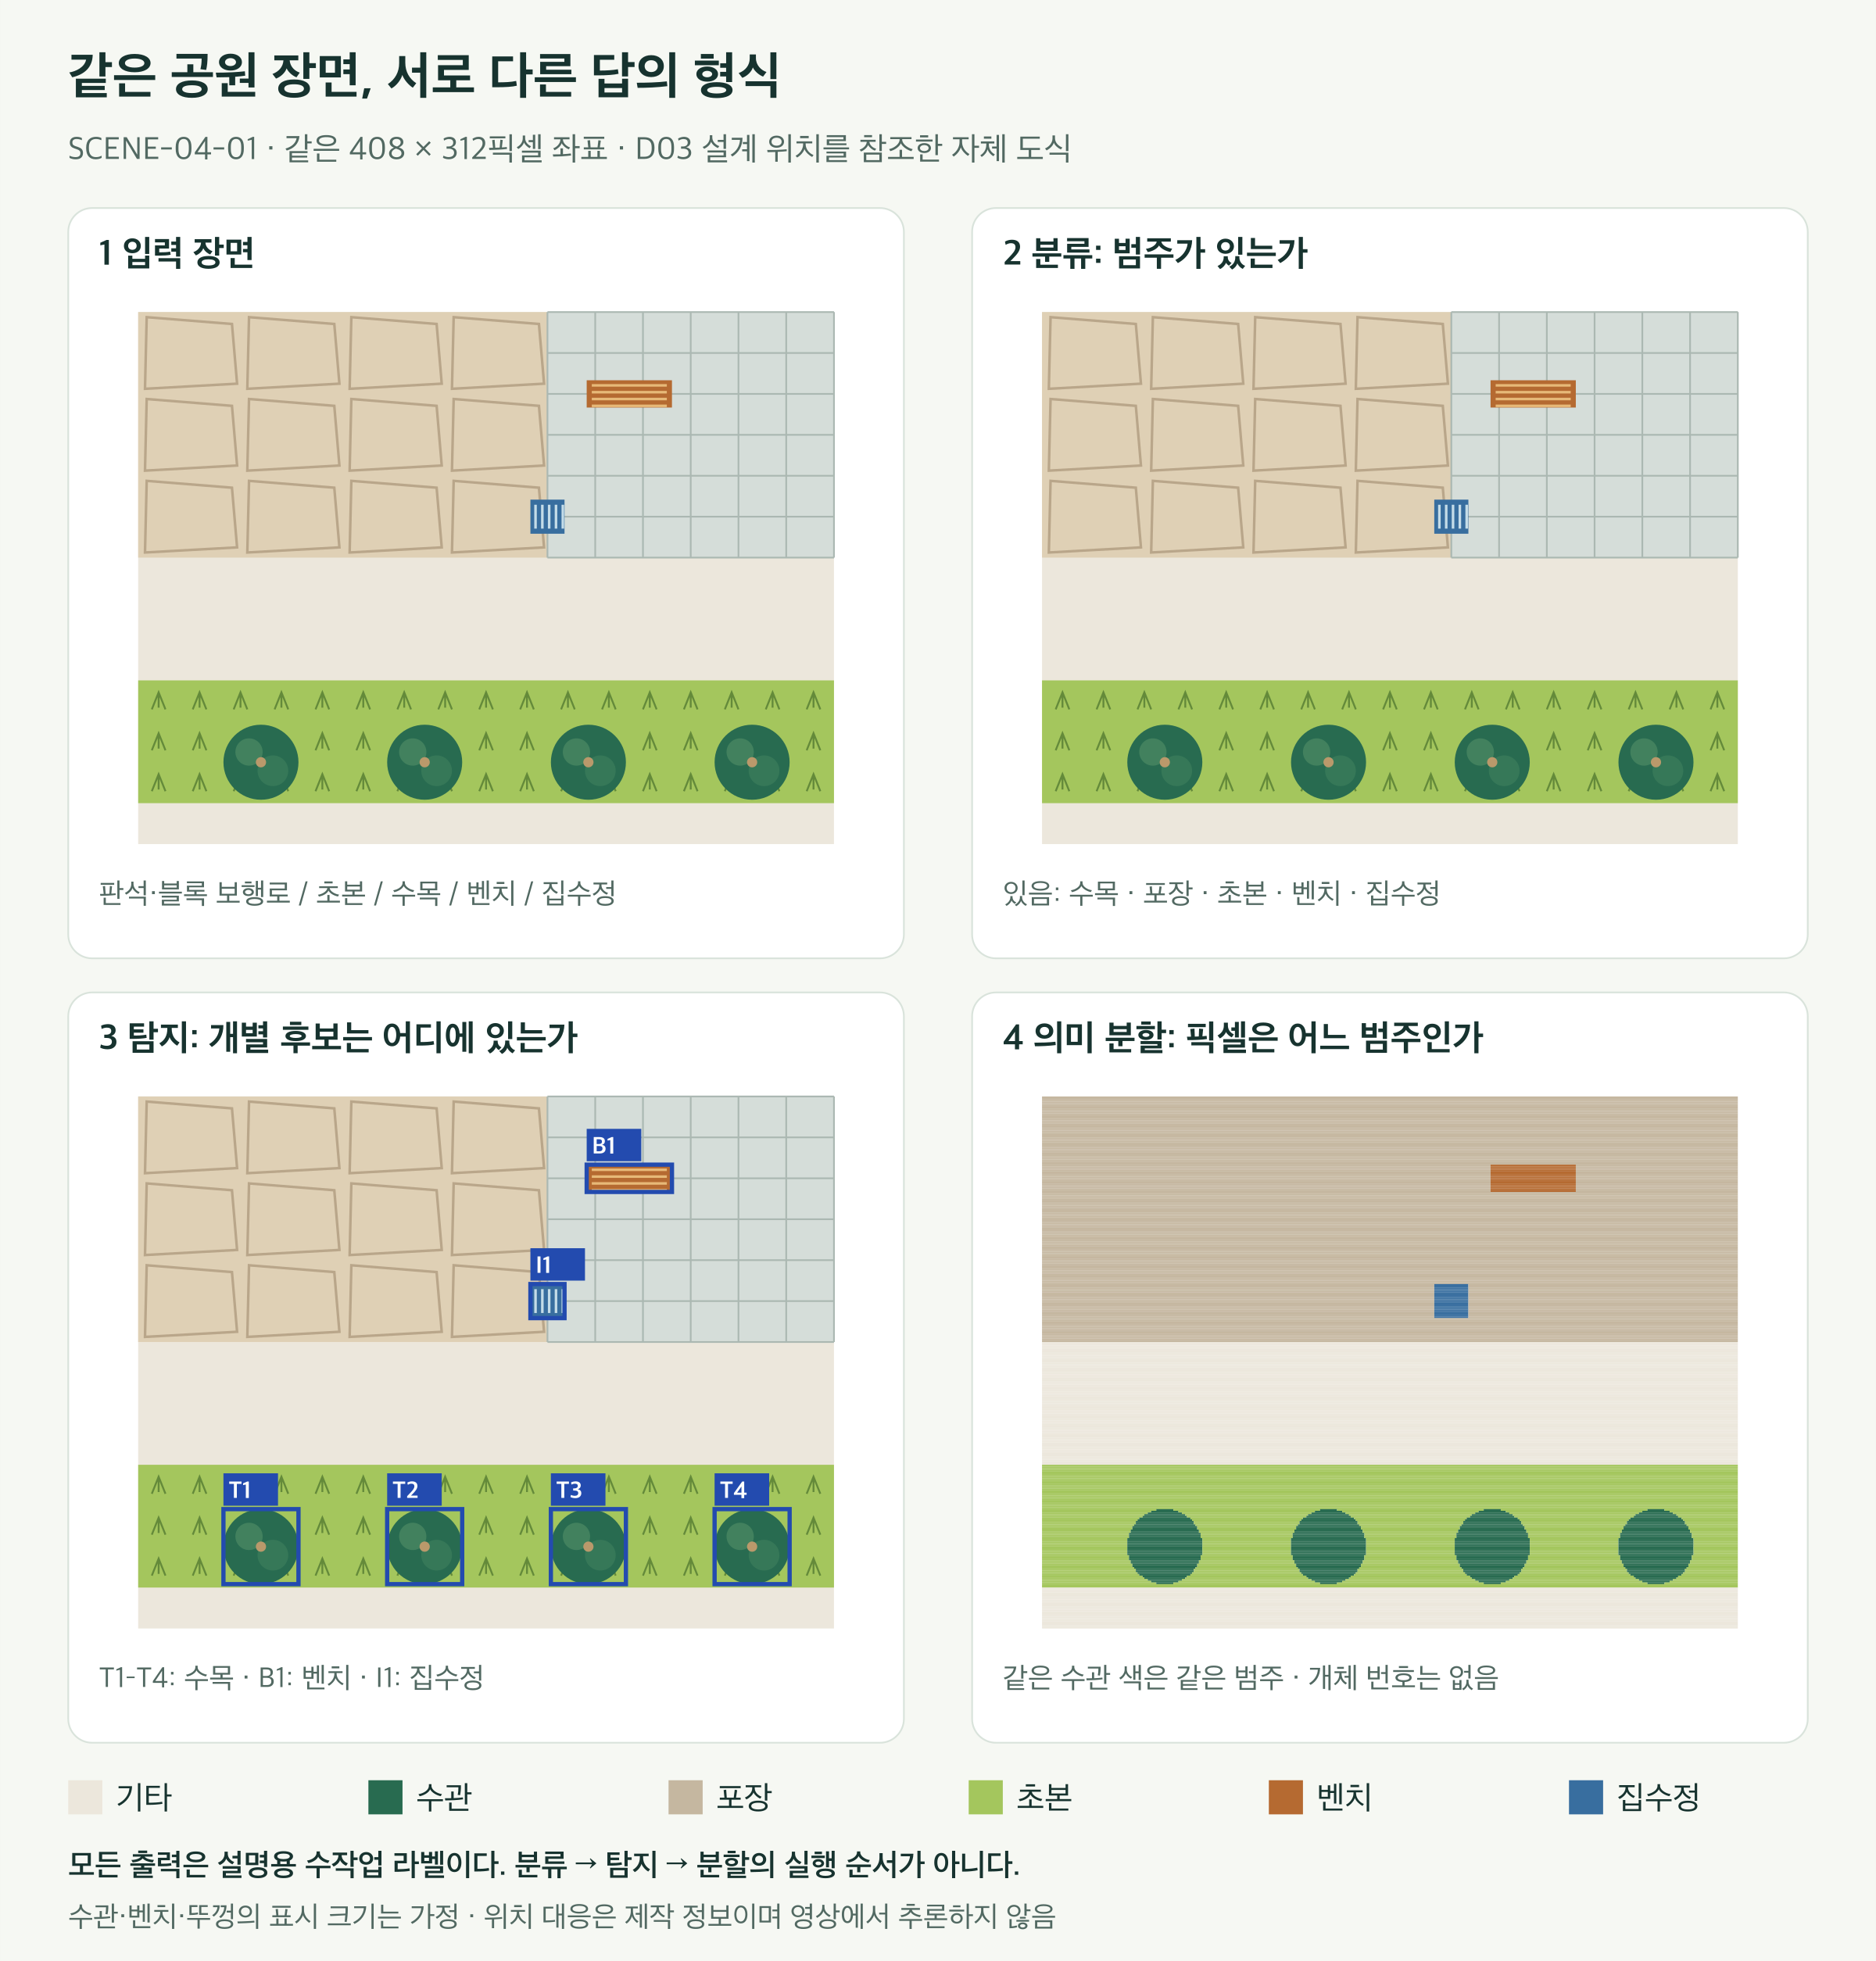
같은 가상 공원 일부를 네 패널로 비교한다. 첫째는 입력 도식, 둘째는 수목·포장·초본·벤치·집수정이 있다는 분류 기록, 셋째는 수목 네 개와 벤치·집수정의 경계 상자 여섯 개, 넷째는 수관·포장·초본·벤치·집수정·기타의 픽셀 범주 지도다. 패널 사이의 배치는 같다.
그림. 하나의 입력에 대한 범주 존재·객체 위치·픽셀 영역의 차이. 자체 도식과 수작업 라벨이며 모델 추론 결과가 아니다. 원 장면의 영상 좌표는 408×312픽셀이다. 분할의 색은 범주 코드에 붙인 범례다. 수관의 그림 크기를 실제 규격으로 해석하지 않는다.
분류: 이 장면에 어떤 범주가 있는가
분류 패널에는 ‘수목 있음·포장 있음·초본 있음·벤치 있음·집수정 있음’이라는 기록을 붙였다. 여러 범주의 존재를 함께 표시하므로 **다중 라벨 분류(multi-label classification)**에 해당하는 출력 형식이다. 장면 전체에서 하나의 대표 범주만 고르는 설정과 구별한다.
이 기록은 사진 목록에서 ‘벤치가 포함된 장면’을 찾는 데 활용할 수 있다. 벤치의 위치나 개수, 포장 면적은 알려 주지 않는다. 여기서는 출력 형식만 비교하기 위해 점수를 붙이지 않았다. 실제 모델을 쓴다면 범주별 점수와 채택 기준도 함께 기록해야 한다.
탐지: 각각 어디에 있는가
탐지 패널에서는 네 수목에 T1–T4, 벤치에 B1, 집수정에 I1을 붙이고 경계 상자로 표시했다. 이 비교에서 선택한 탐지 범주는 수목·벤치·집수정이므로 포장과 초본에는 상자가 없다. 분류와 탐지의 범주 구성을 반드시 같게 정해야 하는 것은 아니다.
상자는 후보 위치를 전달하지만 수관의 실제 경계를 따라가지 않는다. 그림에서는 설명상 여섯 객체를 빠짐없이 표시했어도, 실제 추론에서는 누락·중복·잘못된 위치가 발생할 수 있다. 이 여섯 상자의 수를 가상 공원 전체 수량으로 읽어서도 안 된다.
T1은 이 장면에서 부여한 번호다. 제작 자료에는 D03 객체를 참조한 대응을 남겼지만 이는 그림을 만들 때 알고 있던 연결이다. 실제 사진의 탐지 ID가 BIM 객체 ID로 자동 확정된 사례가 아니다. 현장 연결에는 위치·시점·개체 구분의 별도 확인이 필요하다.
분할: 어떤 픽셀이 어느 범주에 속하는가
의미 분할 패널에서는 보이는 픽셀을 수관·포장·초본·벤치·집수정·기타로 나누었다. 이 예에서는 판석과 블록을 모두 ‘포장’이라는 한 범주에 넣었으므로 원 장면의 무늬 차이가 범주 지도에서는 사라진다. 재료별 면적이 필요한 과제라면 처음부터 판석과 블록을 서로 다른 범주로 정의해야 한다.
초본 위를 가린 수관 픽셀은 수관으로 기록했다. 그 아래 초본이 실제로 없어졌다는 뜻은 아니다. 보이는 피복의 분류와 가려진 지표면의 상태는 다르다. 모든 픽셀에 범주를 붙이는 설정이더라도, 실제 작업에서는 불확실한 픽셀을 제외하거나 미확인 상태로 관리하는 규칙을 추가할 수 있다.
네 수관은 같은 범주 색을 가진다. 각각의 경계를 따로 관리하려면 4.5에서 설명한 개체 분할이 필요하다. 또한 한 장의 장면만으로 시간에 따른 이동이나 변화가 기록되지는 않는다. 추적에는 여러 시점의 입력이, 실제 면적·거리에는 관측 기하와 좌표 대응이 추가로 필요하다.
| 필요한 후속 작업 | 이 비교에서 사용할 출력 | 추가로 확인할 정보 |
|---|---|---|
| 특정 요소가 있는 사진 찾기 | 범주 존재 기록 | 범주 정의, 분류 오류 |
| 수목·시설물 후보 목록 만들기 | 상자와 범주 | 중복·누락, 장면 간 동일 대상 |
| 영상 안 피복 분포 살피기 | 픽셀 범주 지도 | 가림, 분할 오류, 집계 범주 |
| 설계 객체와 비교하기 | 위치·영역의 후보 기록 | 좌표 대응, 객체 ID, 시점과 설계 버전 |
세 과제는 같은 장면을 서로 다른 정보로 바꾼다. 업무에 필요한 답이 무엇인지 정해야 적절한 출력과 검토 기준을 선택할 수 있다.
4.12 현장에서 사용할 영상을 준비하려면
4장에서는 픽셀이 특징과 표현으로 바뀌고, 과제에 따라 범주·상자·마스크 등의 출력이 된다는 흐름을 살펴보았다. 마지막으로 결과의 평가와 불확실성을 연결했다. 실제 활용에서는 이 흐름의 출발점인 입력 자료를 어떻게 만들지가 중요해진다.
예를 들어 집수정 뚜껑이 어디에 있는지 찾는 과제라면, 뚜껑이 영상에서 식별될 만큼 보이고 현장의 위치와 연결할 수 있어야 한다. 수관의 경계를 비교한다면 촬영 시점·시점각·가림과 범주 정의가 영향을 준다. 작은 수종 차이를 구별하려는 입력과 공원 전체의 피복을 살피려는 입력에 같은 촬영 조건이 적합하다고 가정할 수 없다.
5장에서는 분석 질문 → 필요한 영상 정보 → 촬영·수집 → 기준자료 작성 → 결과 확인의 연결을 다룬다. 드론과 현장 카메라가 무엇을 관측할 수 있는지, 영상의 크기와 공간해상도가 대상 식별에 어떤 차이를 만드는지, 반복 관측 자료를 어떻게 정리할지 살펴본다. 여기서 정한 범주·평가 단위·보류 이유는 다음 장에서 수집할 자료의 조건이 된다.
자체 기록과 산술 자료, 출처와 열람 범위를 별도로 남겼다. 실제 촬영·모델 학습·추론·보정·OOD 탐지 실험은 수행하지 않았다.